

¿Cómo resolver errores del servidor o tiempos de espera en solicitudes largas?
Resuelve tiempos de espera con streaming en Cherry Studio o la API BetterToken. Divide tareas largas y revisa el consumo antes de enviar de nuevo la solicitud.
Síntomas
- Envías un texto grande, por ejemplo decenas o cientos de miles de caracteres, o pides una respuesta muy larga.
- Tras varios minutos aparece
Server error, please try again later (openai_error),bad response status code 524, un tiempo de espera agotado o una conexión cerrada. - Las solicitudes cortas funcionan al mismo tiempo, pero cambiar de red, VPN o punto de conexión no soluciona las tareas largas.
Causa
Con la salida sin streaming, el cliente recibe el resultado solo cuando el modelo termina toda la respuesta. Una tarea larga puede superar el tiempo de espera del cliente o de un punto de la conexión antes de recibir el resultado.
Si las solicitudes cortas funcionan y las largas fallan repetidamente, revisa primero el modo de salida y el tamaño de la tarea en lugar de cambiar de VPN continuamente. El error por sí solo no descarta problemas de red o sobrecarga del servicio.
Soluciones
1. Activar streaming
El streaming devuelve contenido por partes y reduce los tiempos de espera por inactividad sin datos de respuesta. Una espera larga hasta el primer fragmento, el límite total del cliente o una sobrecarga aún pueden causar errores.
Cherry Studio
Ruta comprobada en la interfaz en inglés de Cherry Studio 2.0.14:
- Abre el chat del asistente y pulsa su nombre en la parte superior para abrir Edit Assistant (editar asistente).
- Selecciona Model (modelo).
- Comprueba que Stream output (salida en streaming) esté activado.
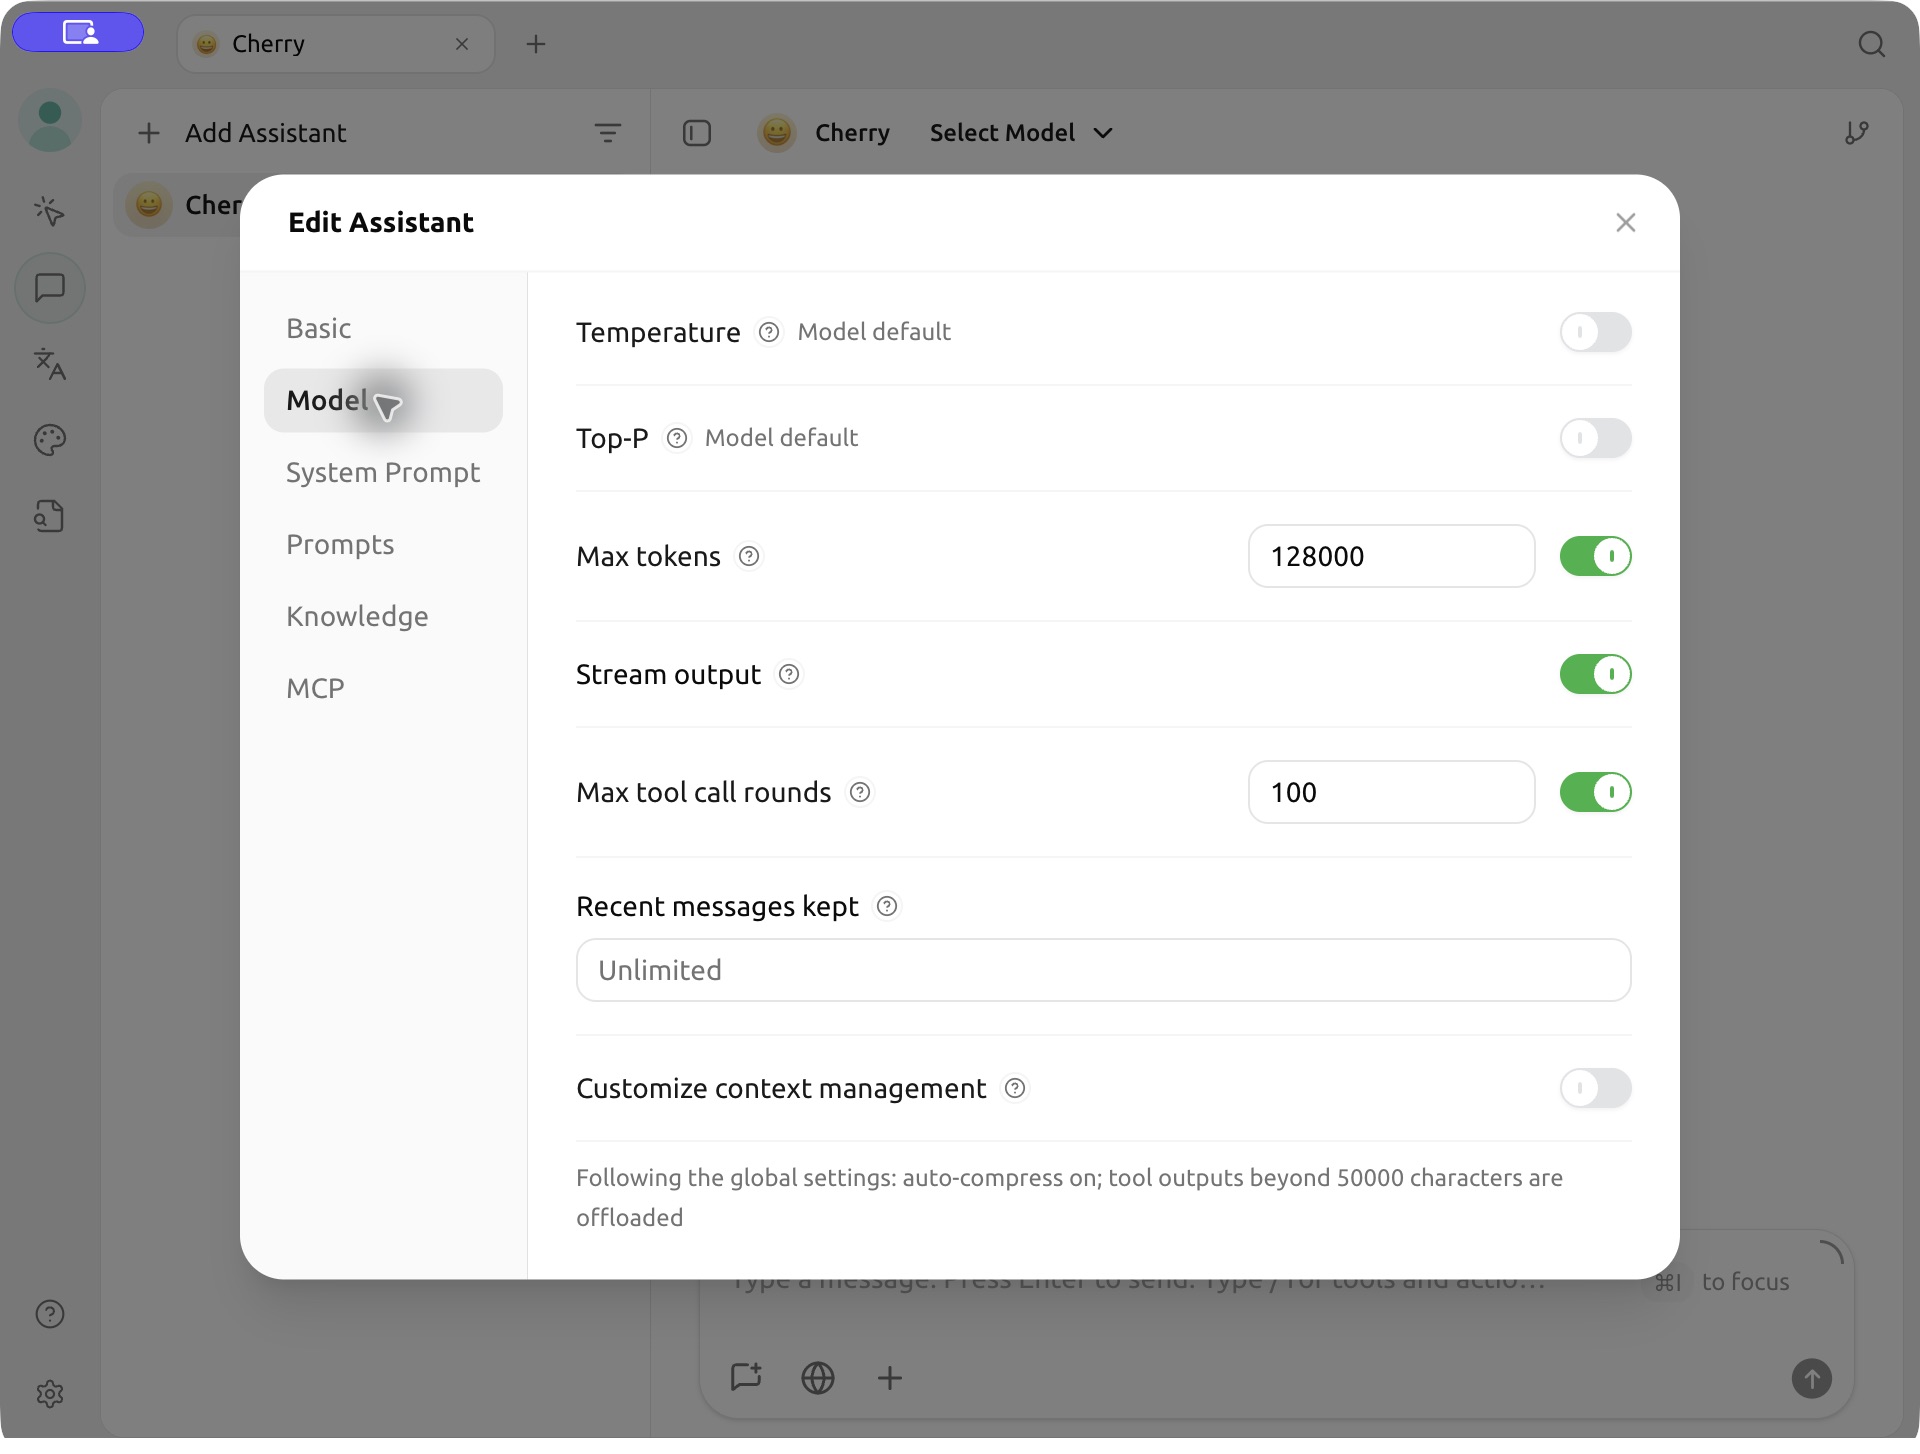
Un usuario de Cherry Studio informó de que activar streaming resolvió los tiempos de espera repetidos en tareas largas.
Llamadas directas a la API
Configura tu BetterToken API Key en la variable de entorno BETTERTOKEN_API_KEY y sustituye ... por tu tarea. Añade "stream": true al cuerpo de la solicitud; --no-buffer desactiva el búfer de salida de curl.
curl --no-buffer https://bettertoken.ai/v1/chat/completions \ -H "Authorization: Bearer $BETTERTOKEN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5-5", "stream": true, "messages": [{"role": "user", "content": "..."}] }'La respuesta llega como eventos SSE, no como un único objeto JSON completo. Con un SDK, utiliza su interfaz de streaming para leer los fragmentos.
2. Dividir la tarea si no hay streaming
Procesa los textos grandes por secciones o pide el resultado por etapas. Si el streaming sigue fallando, reduce la entrada o la extensión de cada respuesta.
3. No reenviar repetidamente la misma solicitud
No esperes que una conexión cerrada se recupere sola. Un tiempo de espera agotado o una desconexión no demuestra que el servidor no haya ejecutado la solicitud ni que no se haya cobrado. Revisa primero el historial de consumo y conserva el ID de solicitud, si existe, y el error antes de decidir si la reenvías. Una nueva solicitud puede ejecutarse y cobrarse de nuevo.
Horas punta
La carga alta puede ralentizar las respuestas y aumentar los tiempos de espera. Las horas punta varían según el modelo y la región; las noches y los fines de semana no garantizan mayor rapidez. Prueba las tareas no urgentes más tarde.
¿El problema continúa?
Envía al soporte:
- La hora aproximada del error, con la zona horaria.
- El Model ID.
- El nombre y la versión del cliente.
- Si estaba activado streaming y si llegó parte de la respuesta antes del error.
- El mensaje de error, el ID de solicitud si existe y la longitud aproximada de la entrada.
No envíes una API Key completa ni texto confidencial.