

長文や長時間のタスクでサーバーエラーやタイムアウトが出た場合は?
長文リクエストの openai_error、524、タイムアウトを解消するため、Cherry Studio のストリーミング設定や API の使い方、タスク分割、再送前の利用履歴確認を説明します。
症状
- 数万〜数十万文字の長い入力を送信したり、非常に長い回答を求めたりしている。
- 数分待つと、
Server error, please try again later (openai_error)、bad response status code 524、タイムアウト、接続切断が表示される。 - 同じ時間帯の短いリクエストは成功するが、ネットワーク、VPN、接続先を変えても長いタスクは失敗する。
原因
非ストリーミング出力では、回答全体の生成が終わってからクライアントが結果を受け取ります。長いタスクでは、結果が届く前にクライアントや通信経路の待機時間を超えることがあります。
短いリクエストは成功し、長いものだけが繰り返し失敗する場合は、VPN を何度も変える前に出力モードとタスクの長さを確認してください。エラーだけでネットワーク障害やサービスの過負荷を除外することはできません。
解決方法
1. ストリーミング出力を有効にする
生成された内容を順次返すことで、応答データが届かない時間が長くなることによるアイドルタイムアウトを減らせます。ただし、最初の応答までの待機、クライアントの総時間制限、過負荷による失敗は起こり得ます。
Cherry Studio
以下の手順は Cherry Studio 2.0.14 の英語 UI で確認しています。
- 対象アシスタントのチャットを開き、上部のアシスタント名をクリックして Edit Assistant(アシスタントを編集)を開きます。
- Model(モデル)を選びます。
- Stream output(ストリーミング出力)がオンになっていることを確認します。
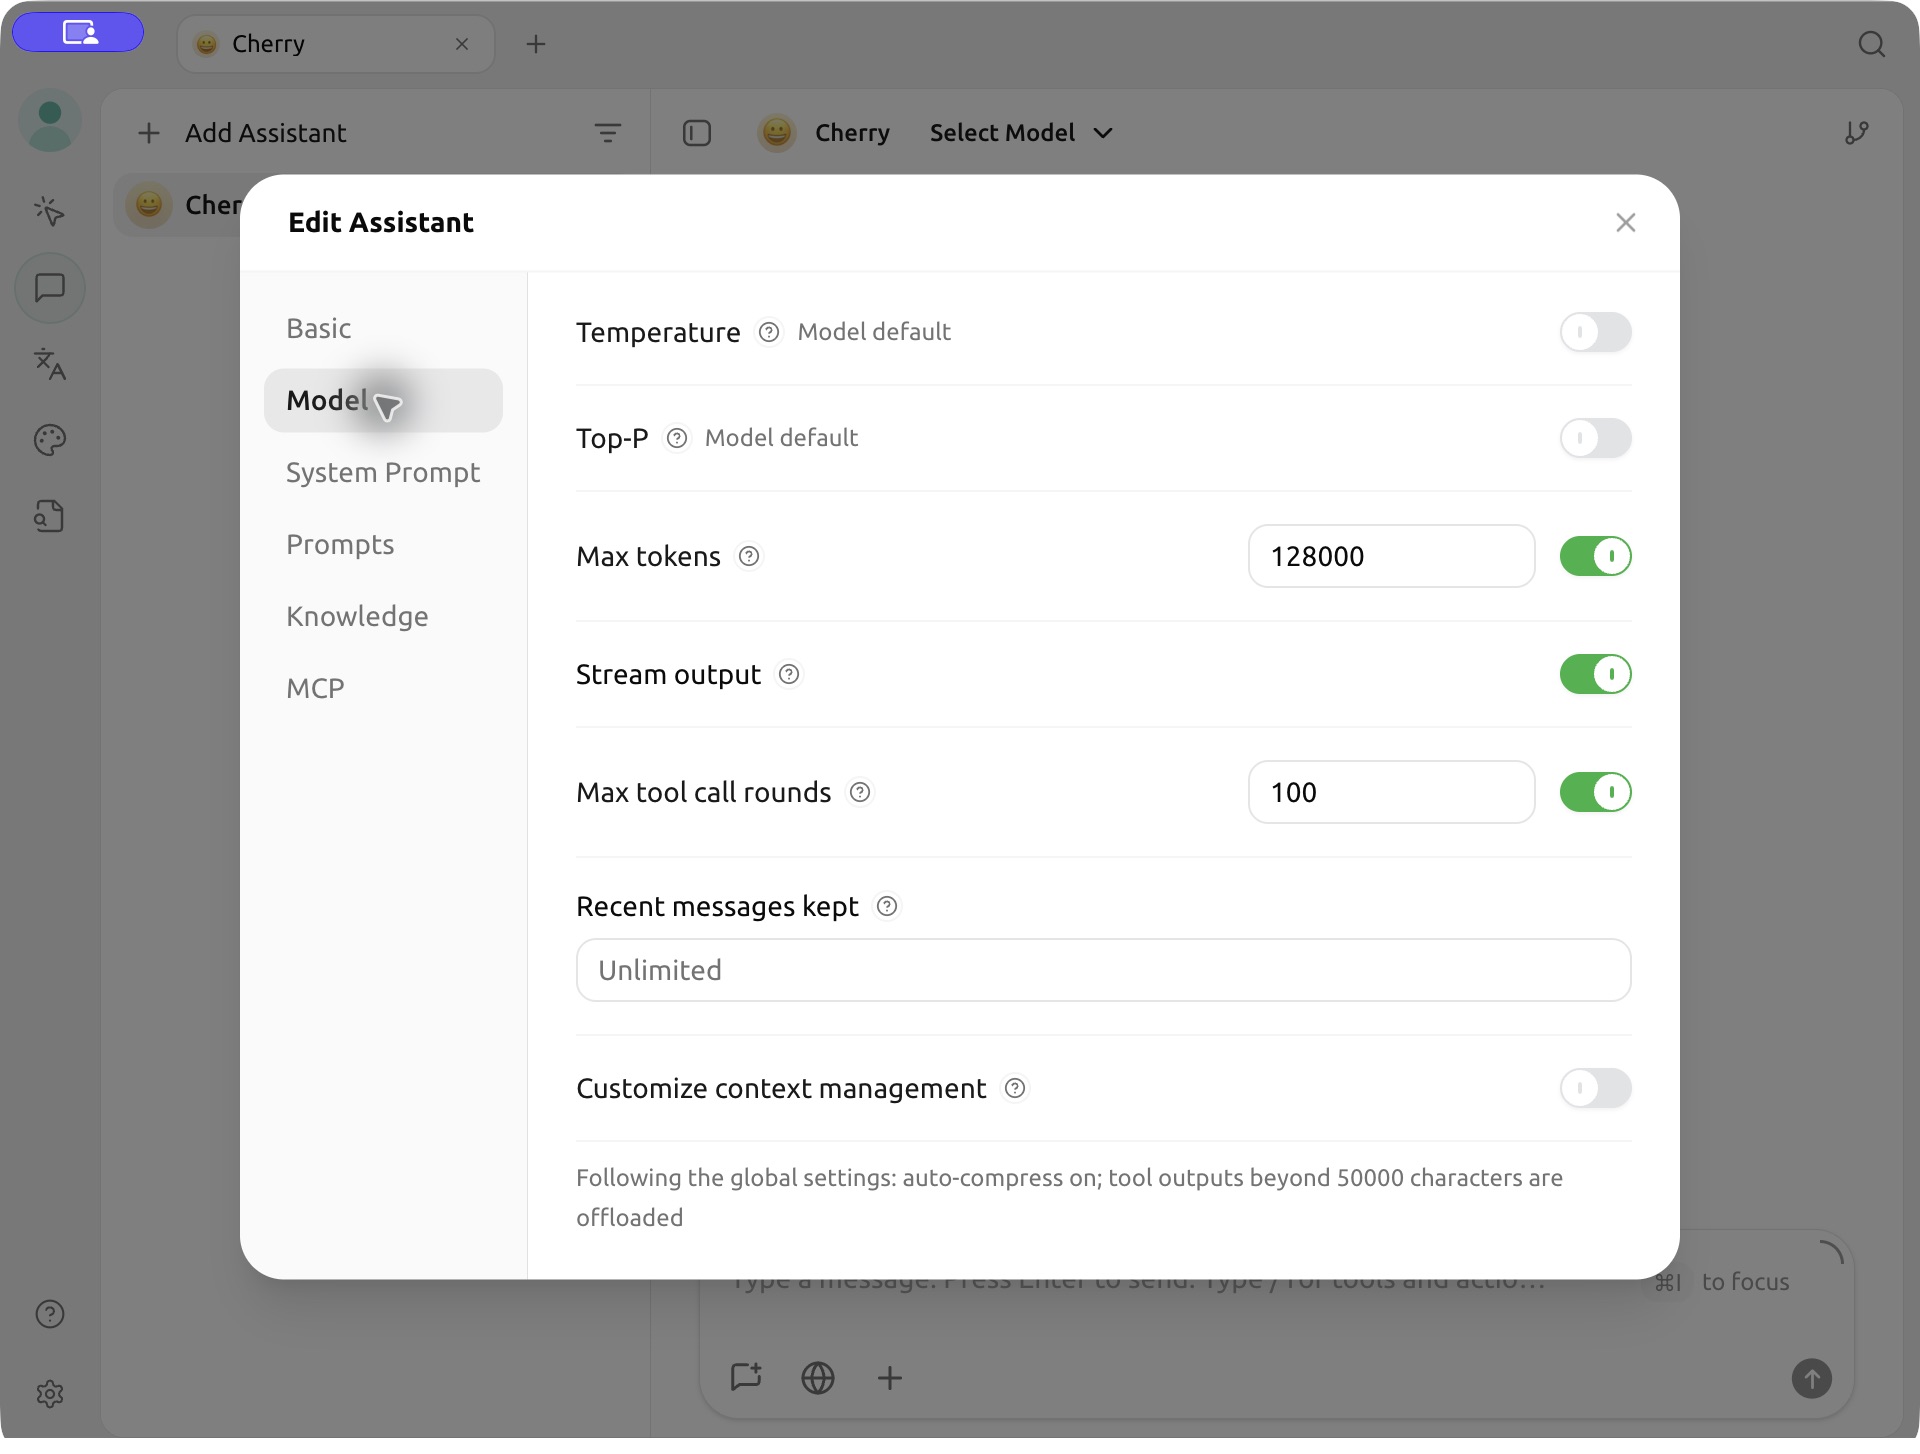
Cherry Studio のユーザーから、ストリーミングを有効にすると長いタスクのタイムアウトが解消したとの報告があります。
API を直接呼び出す場合
BetterToken API Key を環境変数 BETTERTOKEN_API_KEY に設定し、... を実際のタスクに置き換えてください。リクエスト本文に "stream": true を追加します。--no-buffer は curl の出力バッファリングを無効にします。
curl --no-buffer https://bettertoken.ai/v1/chat/completions \ -H "Authorization: Bearer $BETTERTOKEN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5-5", "stream": true, "messages": [{"role": "user", "content": "..."}] }'応答は単一の完全な JSON ではなく、SSE イベントとして順次届きます。SDK ではストリーミング用のインターフェースで読み取ってください。
2. ストリーミングが使えない場合はタスクを分割する
長文を部分ごとに処理するか、結果を段階的に出力させます。有効にしてもタイムアウトする場合は、入力や一度の出力を短くしてください。
3. 同じリクエストをそのまま繰り返さない
閉じた接続が自動的に復旧するのを待たないでください。タイムアウトや切断だけでは、サーバーで実行されなかったことや、料金が発生していないことを確認できません。再送前に利用履歴を確認し、リクエスト ID(ある場合)とエラーを保存してください。再送により再実行・再課金される可能性があります。
混雑する時間帯
負荷が高いと応答が遅くなり、タイムアウトしやすくなります。混雑する時間帯はモデルや地域によって異なり、夜間や週末に速くなる保証はありません。急ぎでないタスクは時間を置いて試してください。
解決しない場合
サポートに次の情報を送ってください。
- エラーのおおよその発生時刻とタイムゾーン。
- Model ID。
- クライアント名とバージョン。
- ストリーミングの有効・無効と、エラー前に回答の一部を受信したか。
- エラー内容、リクエスト ID(ある場合)、おおよその入力長。
API Key 全体や機密性のある原文は送らないでください。