

长文本或长任务报服务器错误、超时怎么办?
长文本或长任务出现 openai_error、524 或连接超时?了解非流式等待的原因,核对 Cherry Studio 的流式输出开关,并通过 API 流式请求、拆分任务和消费记录排查,避免反复重发。
症状
- 输入很长的文本,例如几万到几十万字符,或要求模型生成很长的回答。
- 等待几分钟后,出现
服务器错误,请稍后重试 (openai_error)、bad response status code 524、请求超时或连接关闭。 - 同一时间,短问题可以正常回答;更换网络、VPN 或连接节点后,长任务仍然报错。
原因
客户端使用非流式输出时,要等模型生成完整回答后才收到结果。长任务可能在返回结果前超过客户端或请求链路的等待上限,导致连接中断。
如果短请求正常、长请求反复超时,应先检查输出模式和任务长度,而不是反复更换 VPN。仅凭错误信息,不能排除网络问题或服务过载。
解决办法
1. 打开流式输出
流式模式会逐步返回生成内容,减少长时间没有响应数据造成的空闲超时。首段内容等待过久、客户端总超时或服务过载仍可能导致失败。
Cherry Studio
以下入口已在 Cherry Studio 2.0.14 英文界面核对:
- 打开对应助手的聊天页,点击聊天顶部的助手名称,进入 Edit Assistant(编辑助手)。
- 选择 Model(模型)。
- 确认 Stream output(流式输出)已开启。
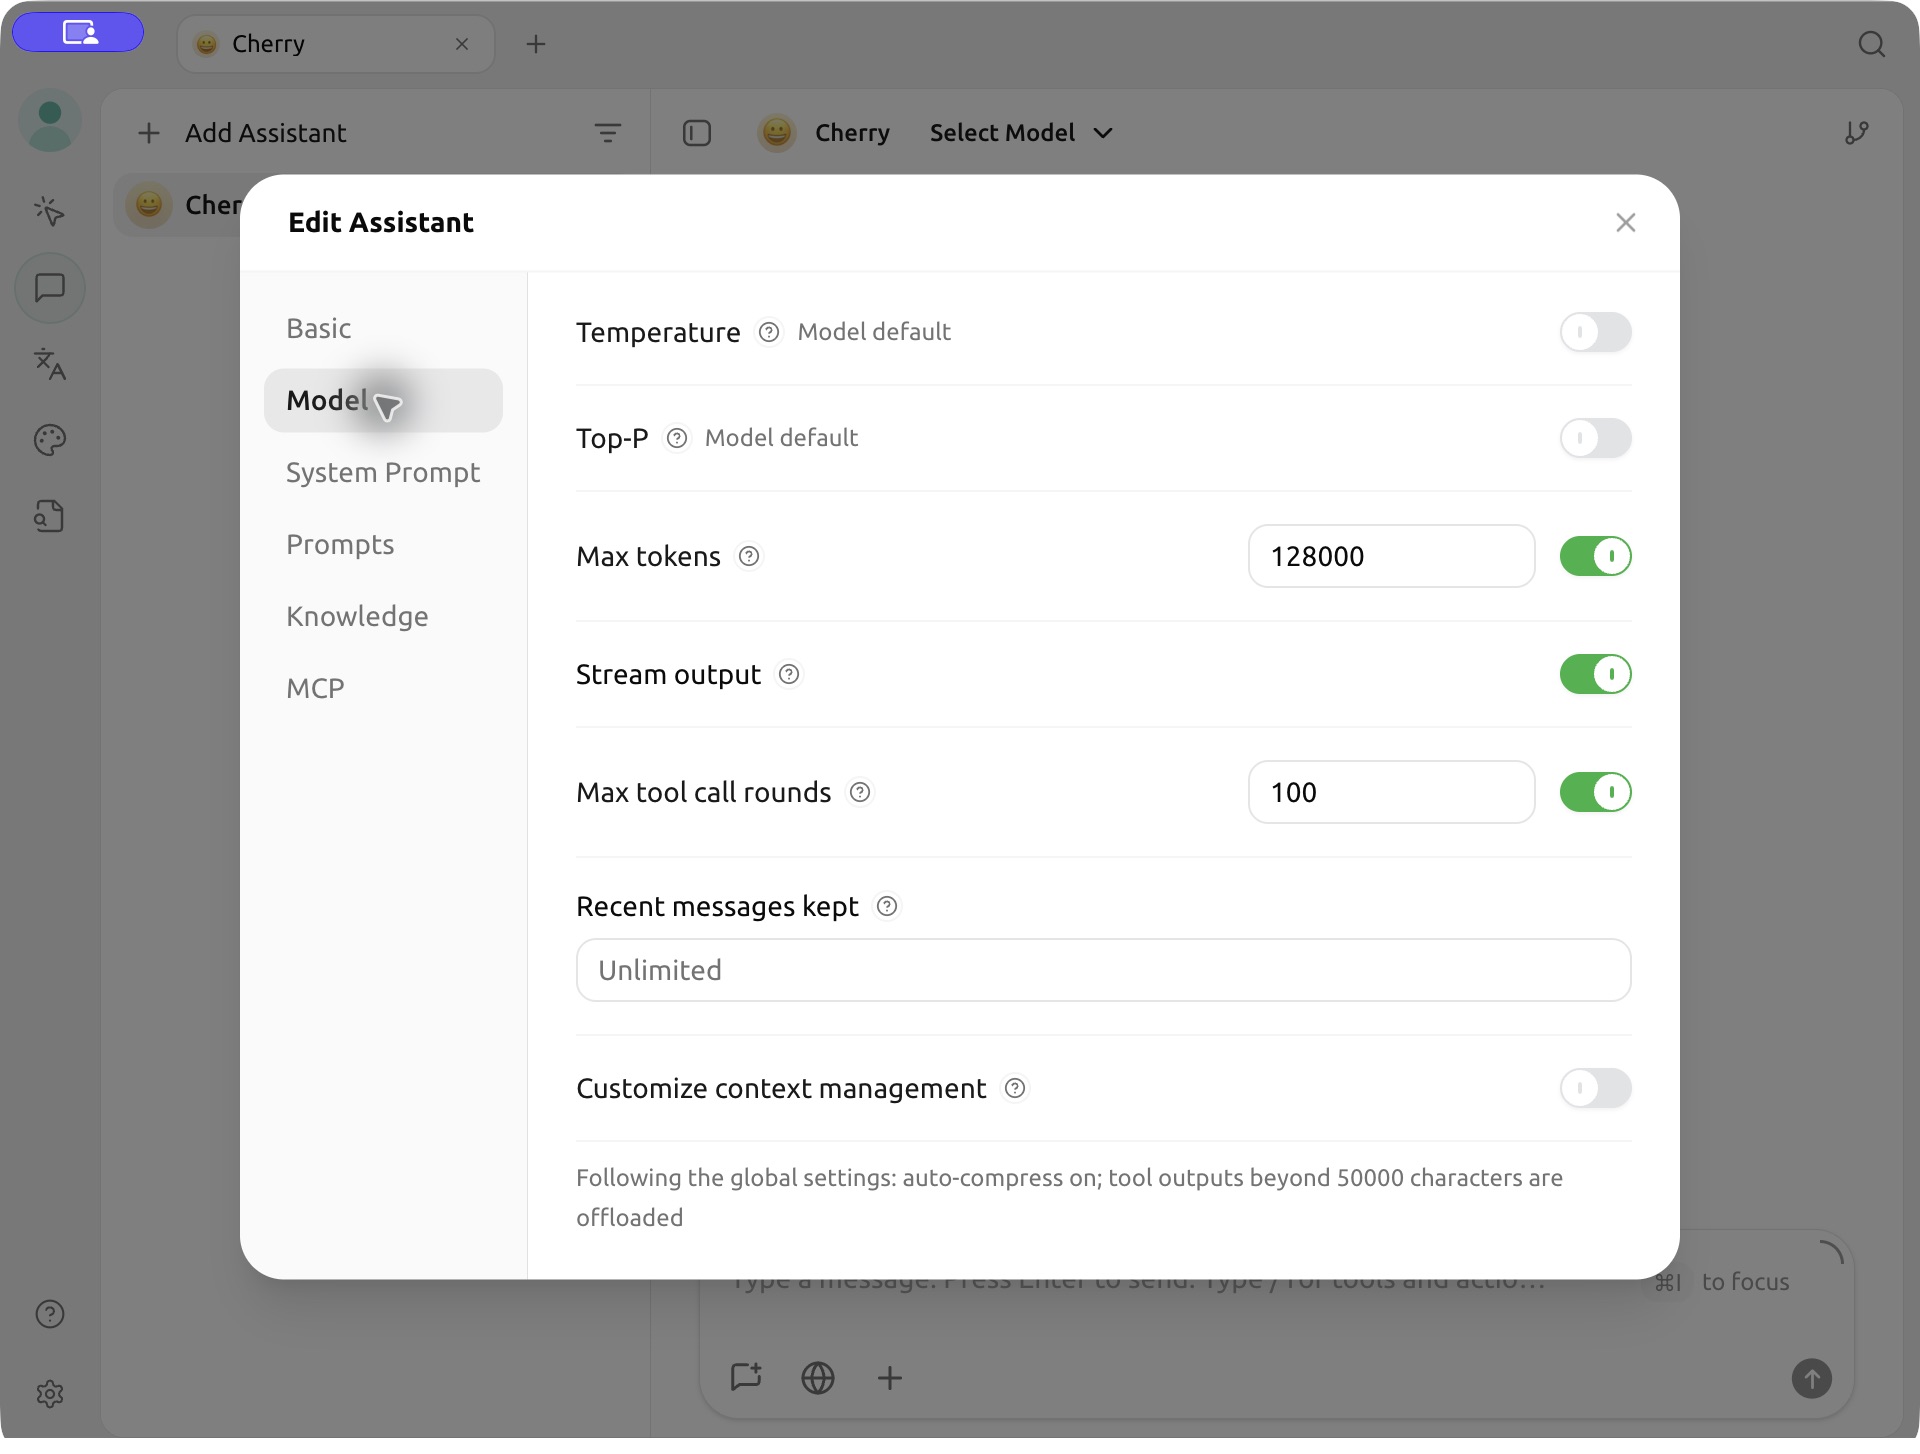
已有用户反馈:在 Cherry Studio 开启流式输出后,原先反复超时的长任务恢复正常。
直接调用 API
先将 BetterToken API Key 设置为环境变量 BETTERTOKEN_API_KEY,把示例中的 ... 替换为你的任务。请求体加入 "stream": true;--no-buffer 用于关闭 curl 的输出缓冲。
curl --no-buffer https://bettertoken.ai/v1/chat/completions \ -H "Authorization: Bearer $BETTERTOKEN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5-5", "stream": true, "messages": [{"role": "user", "content": "..."}] }'响应按 SSE 事件逐段返回,不是单个完整 JSON;使用 SDK 时,需要按其流式接口逐段读取。
2. 无法打开流式时,拆分任务
把大文本分成几段,依次处理;或让模型分步输出,不要一次生成全部结果。已开启流式但仍超时时,也可以缩短输入或单次输出。
3. 不要原样反复重发
连接关闭后,不要等待同一连接自动恢复。超时或断连不代表服务端没有执行,也不能证明一定没有费用。先查看消费记录,保留请求 ID(如有)和错误信息,再决定是否重发;重复提交可能再次执行并计费。
高峰时段说明
高负载时,模型响应可能变慢,更容易触发超时。高峰时段随模型和地区变化,不能保证晚上或周末更快;不紧急的任务可稍后再尝试。
仍然无法解决?
联系支持时,请提供:
- 出错的大致时间,包含时区。
- 使用的 Model ID。
- 客户端名称和版本。
- 是否开启流式输出,以及出错前是否已收到部分回答。
- 错误信息、请求 ID(如有)和大致输入长度。
不要发送完整 API Key 或敏感原文。