

Como resolver erros de servidor ou tempo limite em solicitações longas?
Resolva tempos limite com streaming no Cherry Studio ou na API BetterToken. Divida tarefas longas e confira o consumo antes de enviar a solicitação novamente.
Sintomas
- Você envia um texto grande, como dezenas ou centenas de milhares de caracteres, ou pede uma resposta muito longa.
- Após alguns minutos, aparece
Server error, please try again later (openai_error),bad response status code 524, tempo limite excedido ou conexão encerrada. - Solicitações curtas funcionam no mesmo momento, mas trocar de rede, VPN ou ponto de conexão não resolve as tarefas longas.
Causa
Com a saída sem streaming, o cliente recebe o resultado somente depois que o modelo termina a resposta inteira. Uma tarefa longa pode ultrapassar o tempo limite do cliente ou de uma etapa da conexão antes de retornar o resultado.
Se solicitações curtas funcionam e as longas falham repetidamente, confira primeiro o modo de saída e o tamanho da tarefa, em vez de trocar de VPN continuamente. A mensagem de erro sozinha não descarta problemas de rede ou sobrecarga do serviço.
Soluções
1. Ativar streaming
O streaming retorna conteúdo aos poucos e reduz os tempos limite por inatividade sem dados de resposta. A demora no primeiro trecho, o limite total do cliente ou uma sobrecarga ainda podem causar falhas.
Cherry Studio
O caminho foi verificado na interface em inglês do Cherry Studio 2.0.14:
- Abra o chat do assistente e clique no nome dele no topo para abrir Edit Assistant (editar assistente).
- Selecione Model (modelo).
- Confira se Stream output (saída em streaming) está ativado.
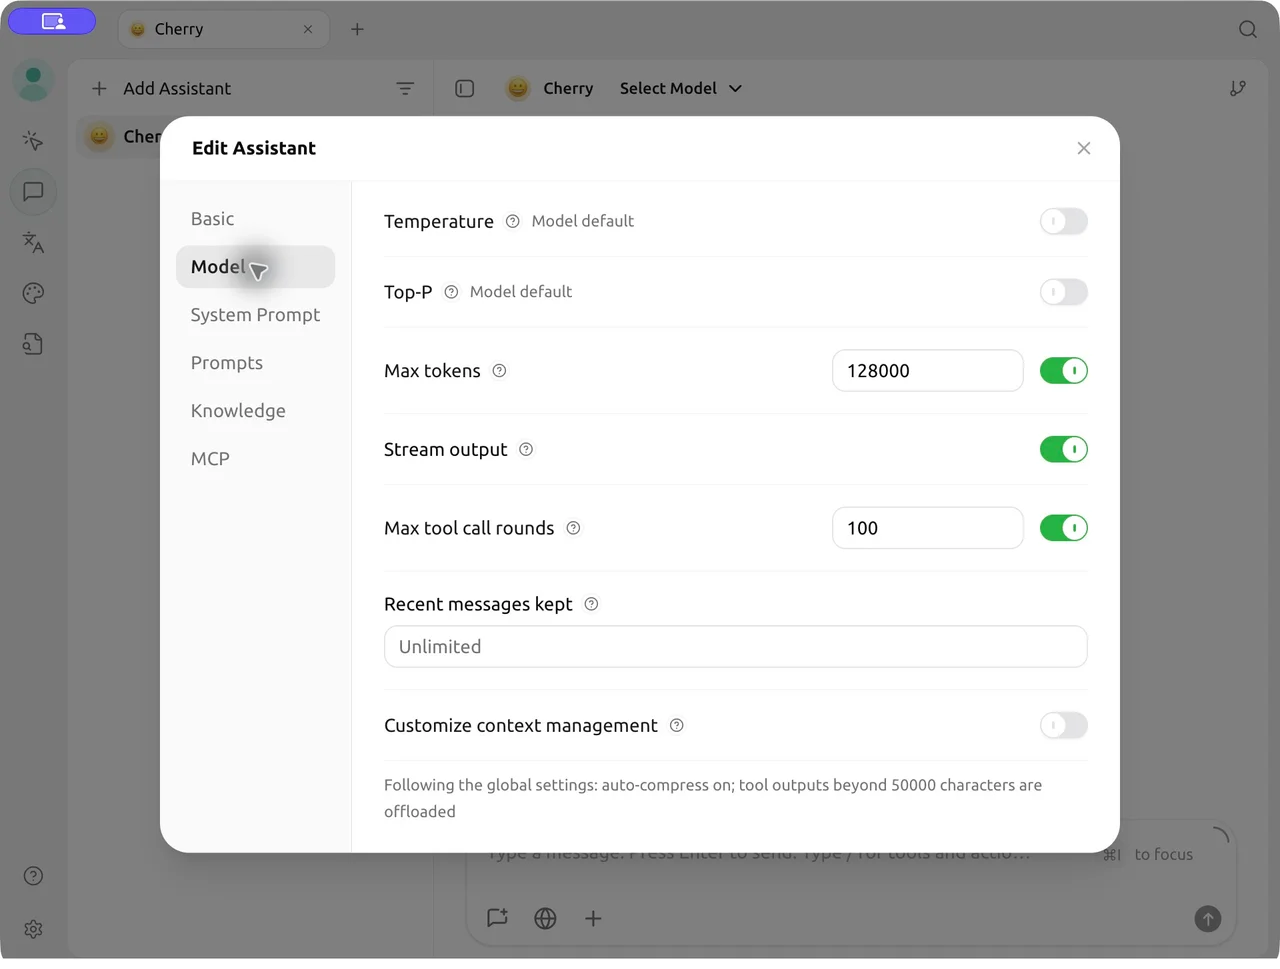
Um usuário do Cherry Studio relatou que ativar streaming resolveu os tempos limite recorrentes em tarefas longas.
Chamadas diretas à API
Defina sua BetterToken API Key na variável de ambiente BETTERTOKEN_API_KEY e substitua ... pela sua tarefa. Adicione "stream": true ao corpo da solicitação; --no-buffer desativa o buffer de saída do curl.
curl --no-buffer https://bettertoken.ai/v1/chat/completions \ -H "Authorization: Bearer $BETTERTOKEN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5-5", "stream": true, "messages": [{"role": "user", "content": "..."}] }'A resposta chega como eventos SSE, não como um único objeto JSON completo. Com um SDK, use a interface de streaming para ler os trechos.
2. Dividir a tarefa quando streaming não estiver disponível
Processe textos grandes por partes ou peça o resultado em etapas. Se o streaming ainda atingir o tempo limite, reduza a entrada ou o tamanho de cada resposta.
3. Não reenviar a mesma solicitação repetidamente
Não espere que uma conexão encerrada se recupere automaticamente. Tempo limite ou desconexão não provam que o servidor deixou de executar a solicitação nem que não houve cobrança. Confira primeiro o histórico de consumo e guarde o ID da solicitação, se disponível, e a mensagem de erro antes de decidir reenviar. Um novo envio pode ser executado e cobrado novamente.
Horários de pico
Carga alta pode tornar as respostas mais lentas e aumentar os tempos limite. Os picos variam por modelo e região; noites e fins de semana não garantem maior velocidade. Tente tarefas não urgentes mais tarde.
O problema continua?
Envie ao suporte:
- Horário aproximado do erro, incluindo o fuso horário.
- Model ID.
- Nome e versão do cliente.
- Se streaming estava ativado e se parte da resposta chegou antes do erro.
- Mensagem de erro, ID da solicitação se disponível e tamanho aproximado da entrada.
Não envie uma API Key completa nem texto confidencial.