

긴 요청에서 서버 오류나 시간 초과가 발생하면 어떻게 하나요?
긴 요청에서 openai_error, 524 또는 연결 시간 초과가 발생할 때 Cherry Studio와 API 스트리밍 설정, 작업 분할, 재전송 전 사용 기록 확인으로 문제를 해결하세요.
증상
- 수만~수십만 자의 긴 텍스트를 보내거나 매우 긴 답변을 요청합니다.
- 몇 분 뒤
Server error, please try again later (openai_error),bad response status code 524, 시간 초과 또는 연결 종료 메시지가 표시됩니다. - 같은 시간에 짧은 요청은 정상 처리되지만 네트워크, VPN, 접속 위치를 바꿔도 긴 작업은 실패합니다.
원인
비스트리밍 출력에서는 모델이 답변 전체를 생성한 뒤에야 클라이언트가 결과를 받습니다. 긴 작업은 결과가 도착하기 전에 클라이언트나 연결 경로의 대기 시간을 초과할 수 있습니다.
짧은 요청은 성공하고 긴 요청만 반복해서 실패한다면 VPN을 계속 바꾸기보다 출력 모드와 작업 크기를 먼저 확인하세요. 오류 메시지만으로 네트워크 문제나 서비스 과부하를 배제할 수는 없습니다.
해결 방법
1. 스트리밍 출력 켜기
스트리밍은 생성된 내용을 순차적으로 반환하여 응답 데이터가 오랫동안 없는 상태에서 발생하는 유휴 시간 초과를 줄입니다. 첫 응답 지연, 클라이언트의 전체 시간 제한, 과부하로 인한 실패는 여전히 발생할 수 있습니다.
Cherry Studio
다음 경로는 Cherry Studio 2.0.14 영어 인터페이스에서 확인했습니다.
- 해당 어시스턴트의 채팅을 열고 상단 이름을 눌러 Edit Assistant(어시스턴트 편집)를 엽니다.
- Model(모델)을 선택합니다.
- Stream output(스트리밍 출력)이 켜져 있는지 확인합니다.
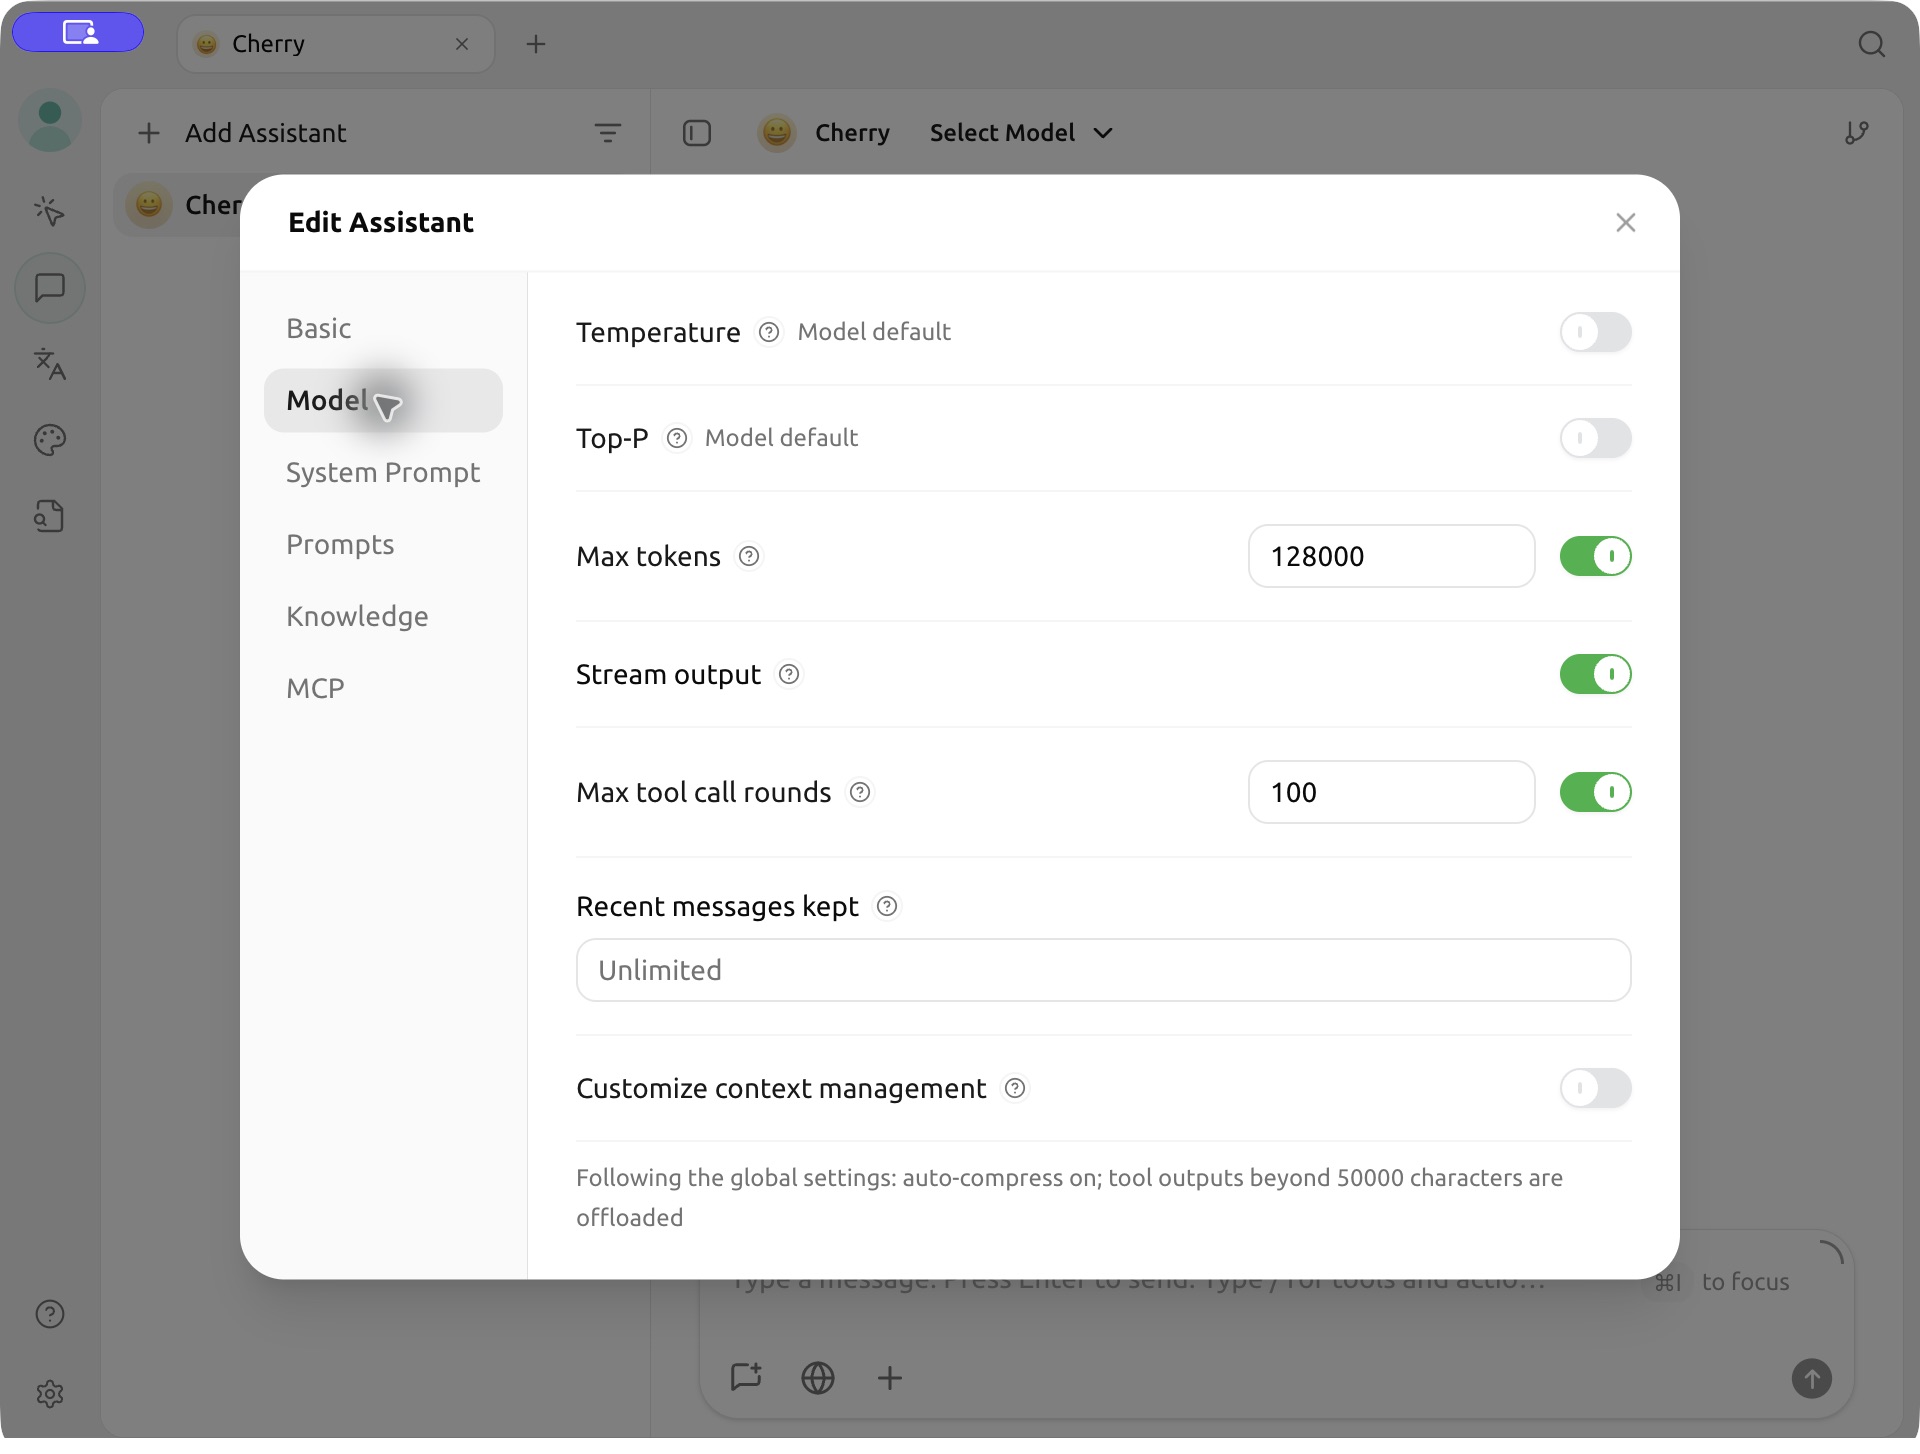
Cherry Studio 사용자가 스트리밍을 켠 뒤 긴 작업의 반복적인 시간 초과가 해결되었다고 보고한 사례가 있습니다.
API 직접 호출
BetterToken API Key를 BETTERTOKEN_API_KEY 환경 변수에 설정하고 ...을 실제 작업으로 바꾸세요. 요청 본문에 "stream": true를 추가합니다. --no-buffer는 curl 출력 버퍼링을 끕니다.
curl --no-buffer https://bettertoken.ai/v1/chat/completions \ -H "Authorization: Bearer $BETTERTOKEN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "claude-opus-5-5", "stream": true, "messages": [{"role": "user", "content": "..."}] }'응답은 완성된 단일 JSON 객체가 아니라 SSE 이벤트로 나누어 도착합니다. SDK에서는 스트리밍 인터페이스로 각 부분을 읽으세요.
2. 스트리밍을 사용할 수 없다면 작업 나누기
큰 텍스트를 부분별로 처리하거나 결과를 단계별로 요청하세요. 스트리밍을 켜도 시간 초과가 발생하면 입력이나 한 번의 출력 길이를 줄이세요.
3. 같은 요청을 그대로 반복 전송하지 않기
종료된 연결이 자동으로 복구되기를 기다리지 마세요. 시간 초과나 연결 끊김은 서버가 요청을 실행하지 않았거나 요금이 발생하지 않았다는 증거가 아닙니다. 재전송을 결정하기 전에 사용 기록을 확인하고 요청 ID가 있으면 오류 정보와 함께 보관하세요. 재전송하면 다시 실행되고 과금될 수 있습니다.
혼잡 시간대
부하가 높으면 응답이 느려지고 시간 초과가 늘어날 수 있습니다. 혼잡 시간은 모델과 지역에 따라 달라지며 야간이나 주말에 더 빠르다는 보장은 없습니다. 급하지 않은 작업은 나중에 시도하세요.
계속 문제가 발생하나요?
지원팀에 다음 정보를 보내주세요.
- 오류 발생 시각과 시간대.
- Model ID.
- 클라이언트 이름과 버전.
- 스트리밍 사용 여부와 오류 전에 답변 일부를 받았는지 여부.
- 오류 내용, 요청 ID(있는 경우), 대략적인 입력 길이.
전체 API Key나 민감한 원문은 보내지 마세요.