gpt-image-2, gpt-image-2.5-flare y gpt-image-2.5-sunburst, muchos desarrolladores se encuentran con varias preguntas difíciles:
- ¿Por qué varían los resultados entre llamadas con el mismo modelo y los mismos parámetros?
- ¿Por qué, aunque se solicite 4K o un tamaño específico, la imagen recibida se reduce a 1K?
- ¿El retoque localizado con
Maskoquality=highrealmente se aplica? ¿Con qué criterio se cobra al final?
200 OK: deben cumplirse a la vez estas tres condiciones: generar la imagen, poder usarla en el diseño previsto y tener costes transparentes y previsibles.
Para ayudar a los desarrolladores a entender el comportamiento real de estos tres modelos, BetterToken ha implementado a nivel interno enrutamiento inteligente según las capacidades, limpieza de parámetros predeterminados, bloqueo previo de parámetros no válidos y facturación transparente basada en los píxeles realmente entregados. Esta guía se basa en los datos de las pruebas más recientes y en una instantánea de precios del 19 de octubre de 2026. Con imágenes originales generadas y facturas reales, te muestra cómo realizar las llamadas, qué resultados puedes obtener y qué límites objetivos siguen teniendo los propios modelos.
Nota: Esta guía se centra engpt-image-2,gpt-image-2.5-flareygpt-image-2.5-sunburst. Los parámetros y el sistema de facturación de la serie Nano Banana son diferentes; los explicaremos en otro artículo para evitar confusiones.
1. ¿Por qué pueden variar los resultados con el mismo modelo y los mismos parámetros?
En el uso real, los distintos nodos de servicio que hay detrás del mismo nombre de modelo suelen diferir en capacidad y estabilidad: algunas rutas solo admiten imágenes básicas de 1K, mientras que otras entregan imágenes de alta resolución de2048×2048 o incluso 3840×2160. También varía entre nodos el grado de compatibilidad con los valores de quality, la edición con imágenes de referencia y las máscaras Mask.
Si una plataforma simplemente reenvía las solicitudes a ciegas según el nombre del modelo, los desarrolladores se encontrarán a menudo con situaciones como «solicité 4K, pero recibí una imagen pequeña de 1K», «envié una Mask y la solicitud dio error» o «tengo que ajustar los parámetros una y otra vez». Por eso necesitamos un estándar de pruebas riguroso que verifique por separado si la interfaz acepta los parámetros y cuál es el resultado realmente entregado.
2. Cómo probamos: ¿qué consideramos «compatible»?
Para que las conclusiones sean objetivas y fiables, diseñamos 22 escenarios de prueba estándar para la regresión de la versión estable (17 solicitudes válidas entregaron 18 imágenes; los 5 casos con parámetros no válidos se bloquearon según lo previsto y no generaron cargos) y, además, generamos imágenes de productos y muestras de edición con Mask para escenarios habituales de comercio electrónico. Nuestros criterios de verificación son directos:- Decodificar los píxeles del archivo original: no confiamos sin más en lo que declara la interfaz. Decodificamos las dimensiones de cada imagen entregada a partir del archivo original y las contrastamos con el nivel de facturación indicado en la respuesta y el cargo real en la cuenta.
- Determinar si se alcanza el tamaño: comparamos por separado el ancho y el alto solicitados de forma explícita. Si las dimensiones reales son mayores, se considera aprobado; si cualquiera de los lados queda más de un 5% por debajo del tamaño objetivo, se considera que no lo alcanza (nota: este criterio sirve para evaluar estrictamente los resultados de la prueba; no significa que la API descarte automáticamente las imágenes válidas que no alcancen el tamaño solicitado). Si se omite el tamaño o se envía
auto, no se considera que haya un lienzo fijo como objetivo. - Separar la aceptación de parámetros del resultado real: que la interfaz no dé error solo significa que «acepta el parámetro». Para determinar si
Maskaísla estrictamente una zona o siquality=highmejora la imagen de forma visible, hay que examinar el resultado final.
3. Resultados de las pruebas: ¿qué parámetros se malinterpretan con más facilidad?
Al comparar los parámetros solicitados, los píxeles realmente entregados y la factura final, encontramos varios hechos clave que los desarrolladores suelen interpretar mal:
Además, las pruebas mostraron lo siguiente sobre la compatibilidad de parámetros y la gestión de errores:
- Tolerancia a parámetros predeterminados: la imagen se genera correctamente tanto si
qualityysizese omiten, se envían comonullo se especifican como"auto". - Cómo solicitar 4K correctamente: «4K» es un concepto de nivel de facturación y no significa que se admitan imágenes cuadradas de
4096x4096. Para obtener una imagen grande de alta resolución de nivel 4K, usa el tamaño horizontal3840x2160. - Bloqueo de parámetros no válidos sin cargos: al enviar
4096x4096,stream=true, una cadena vacíaquality="", una cadena vacíasize=""on=0, todas las solicitudes de prueba devolvieron un errorHTTP 400y no generaron ningún cargo.
4. Qué ofrece BetterToken: no tienes que adaptar cada ruta por separado
Ante las variaciones de tamaño y las diferencias entre nodos de los modelos subyacentes, BetterToken se ocupa de cuatro aspectos en la capa de gateway para que no tengas que escribir código de adaptación para cada ruta:- Enrutamiento inteligente según las capacidades: el sistema selecciona automáticamente un servicio disponible con las capacidades correspondientes, según el modelo, el tamaño objetivo (por ejemplo, 2K/4K) y si se incluyen parámetros de edición de imágenes o
Mask. - Interfaz unificada y valores alternativos para los parámetros: las interfaces estándar
POST /v1/images/generations(generación de imágenes) yPOST /v1/images/edits(edición con imagen de referencia/Mask) procesan automáticamente los valoresnull,autoy los parámetros omitidos, y bloquean las entradas no válidas directamente en el gateway. - Devolución transparente de las dimensiones reales y los detalles de facturación: junto con los datos de la imagen, el campo
bettertoken_image_billingdel cuerpo de la respuesta indica directamente el ancho y alto decodificados reales (width/height), el nivel de facturación (billing_resolution), la moneda y el importe liquidado (settled_amount). - Distinción clara entre dos conceptos fundamentales:
- Admitir el parámetro
Mask≠ garantizar un retoque preciso a nivel de píxel: la interfaz permite subir una imagen de referencia y una Mask para editar, pero algunos resultados de las pruebas también modificaron zonas protegidas fuera de la máscara. Por ejemplo, en nuestra prueba geométrica de dos círculos, se pidió cambiar el color del círculo izquierdo transparente y proteger el derecho opaco, pero se cambiaron ambos. Por eso, confirmamos que se admite el envío del parámetro Mask, pero no garantizamos que se consiga siempre un aislamiento estricto de las zonas a nivel de píxel. - Admitir el parámetro
quality≠ garantizar una mejora fija de la calidad: la interfaz admite valores como"auto"o"high"y los enruta correctamente. Sin embargo, como la generación tiene un componente aleatorio, no prometemos a partir de una sola muestra quehighproporcione una mejora de calidad de un porcentaje determinado.
- Admitir el parámetro
⚠️ Dos límites reales que debes conocer antes de integrar:
- Enrutar según las capacidades no equivale a fijar estrictamente los píxeles en cada llamada: por las diferencias de salida de los servicios subyacentes, los píxeles reales pueden variar incluso si la solicitud se enruta al nodo correcto (por ejemplo, hoy hubo solicitudes de
1024x1024que devolvieron1024×936, y muestras de solicitudes de3840x2160que devolvieron3840×2161). Si la proporción del lienzo es crítica para tu aplicación, recorta o procesa la imagen después según el ancho y alto reales de la respuesta.- Solicitar 1K no siempre implica que se facture como 1K: el sistema clasifica la imagen según las dimensiones de la imagen válida realmente entregada. Hoy, dos modelos 2.5 (y algunos casos de
gpt-image-2) devolvieron1254×1254al recibir solicitudes de1024x1024; el sistema las clasificó como nivel 2K y las facturó según la tarifa correspondiente.
5. Compatibilidad de los tres modelos: ¿cuál debo llamar y qué valores debo enviar?
La configuración de capacidades y la cobertura de pruebas actuales degpt-image-2, gpt-image-2.5-flare y gpt-image-2.5-sunburst son las siguientes:
Nota: «Probado en esta ronda» significa que las pruebas de regresión y la generación de casos de hoy entregaron directamente imágenes y muestras de facturación. «Configuración de enrutamiento alineada para admitirlo» significa que la plataforma ya alineó la configuración del canal de esa capacidad, pero no repitió hoy las solicitudes para todas las combinaciones posibles.
6. Dos casos con imágenes reales: ¿qué resultados ofrecen?
Para mostrar la calidad de generación más real posible, seguimos la estructura «sujeto explícito + textura del material + dirección de la luz + proporción de composición + elementos que se deben excluir» de la guía oficial de OpenAI para prompts de imágenes y generamos los dos casos de comercio electrónico que aparecen a continuación mediante la interfaz real de BetterToken (se conservan las salidas originales, sin retoques posteriores).Caso A: fotografía de producto para comercio electrónico; dimensiones y detalles en 1K / 2K / 4K
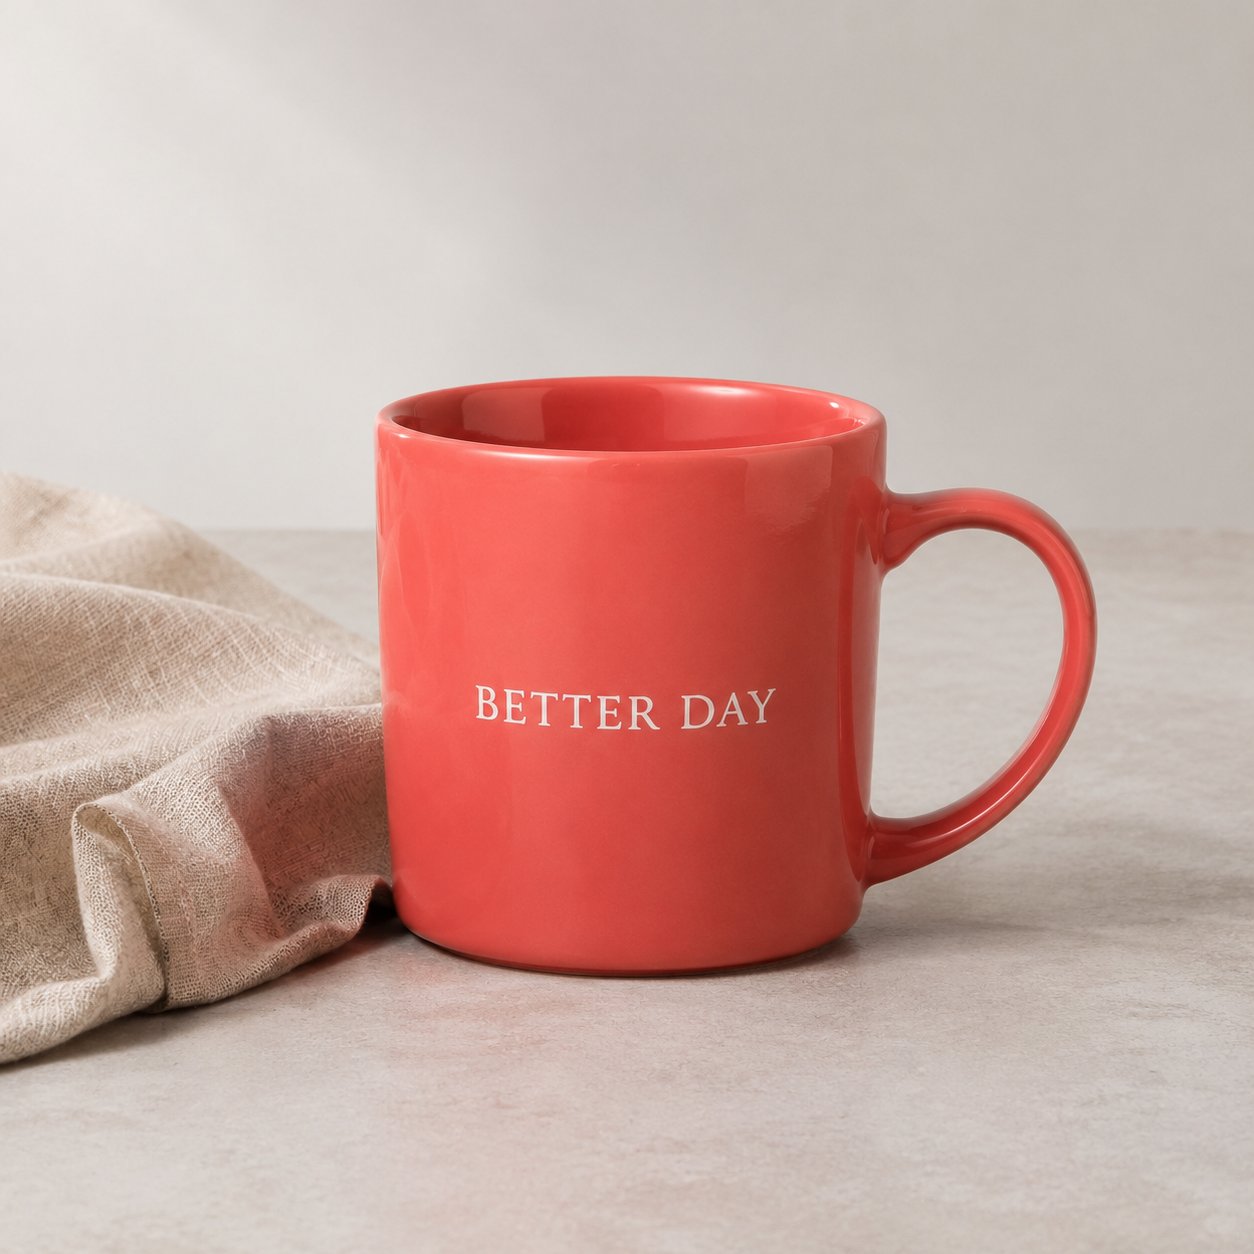
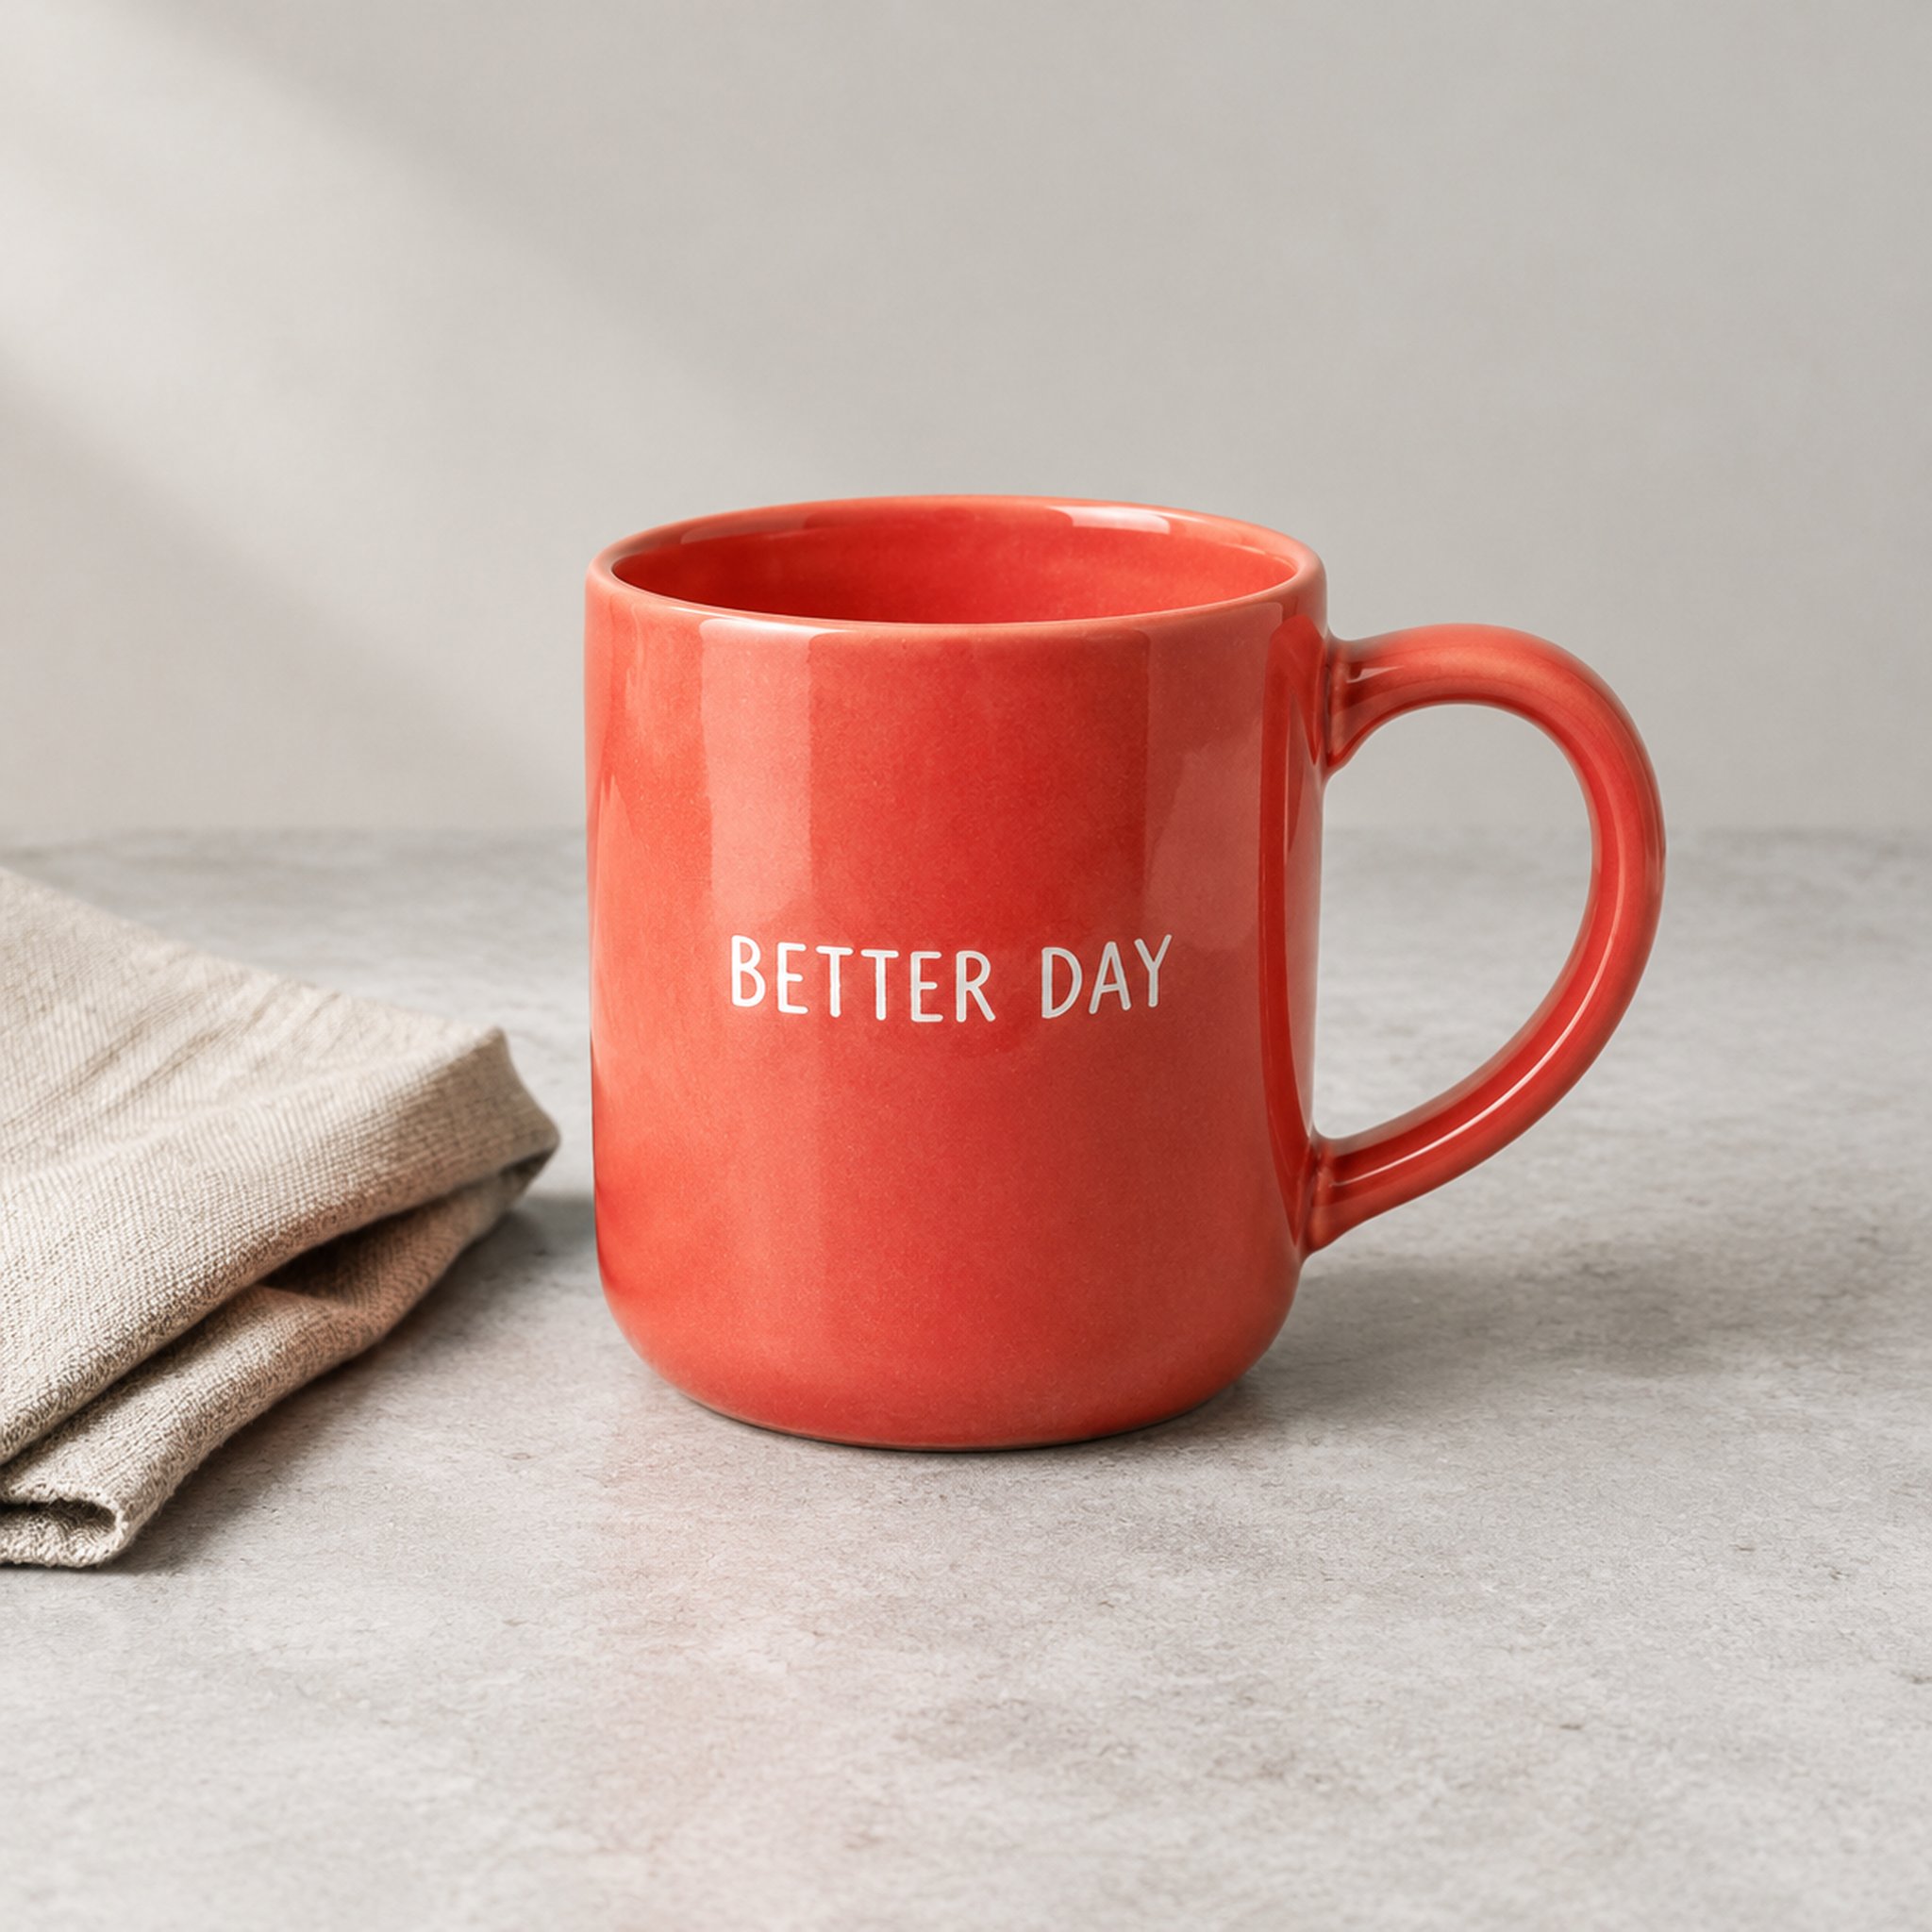
Diseño de la escena (concepto en chino):Genera una fotografía realista de estudio para comercio electrónico: una taza de cerámica de color rojo coral (con el asa hacia la derecha) sobre una encimera de piedra gris claro, con un paño de lino beige doblado a la izquierda. La taza lleva el texto blanco y nítido «BETTER DAY». Luz lateral suave desde arriba a la izquierda; conserva los reflejos sutiles del esmalte cerámico, las fibras del lino y las sombras de contacto naturales. La taza aparece completa y centrada; el fondo es sencillo y neutro, sin otros objetos, marcas de agua ni texto adicional.Prompt real enviado en inglés:
gpt-image-2 (quality="high", 1 imagen por generación), mantuvimos exactamente el mismo Prompt y solicitamos tres tamaños distintos exclusivamente mediante el parámetro size, sin añadir «4K» al prompt para forzar el resultado:
1. Imagen original entregada para la solicitud
1024x1024 (devolvió 1254×1254):
2048x2048 (devolvió 2048×2048):
3840x2160 (devolvió 3840×2161):
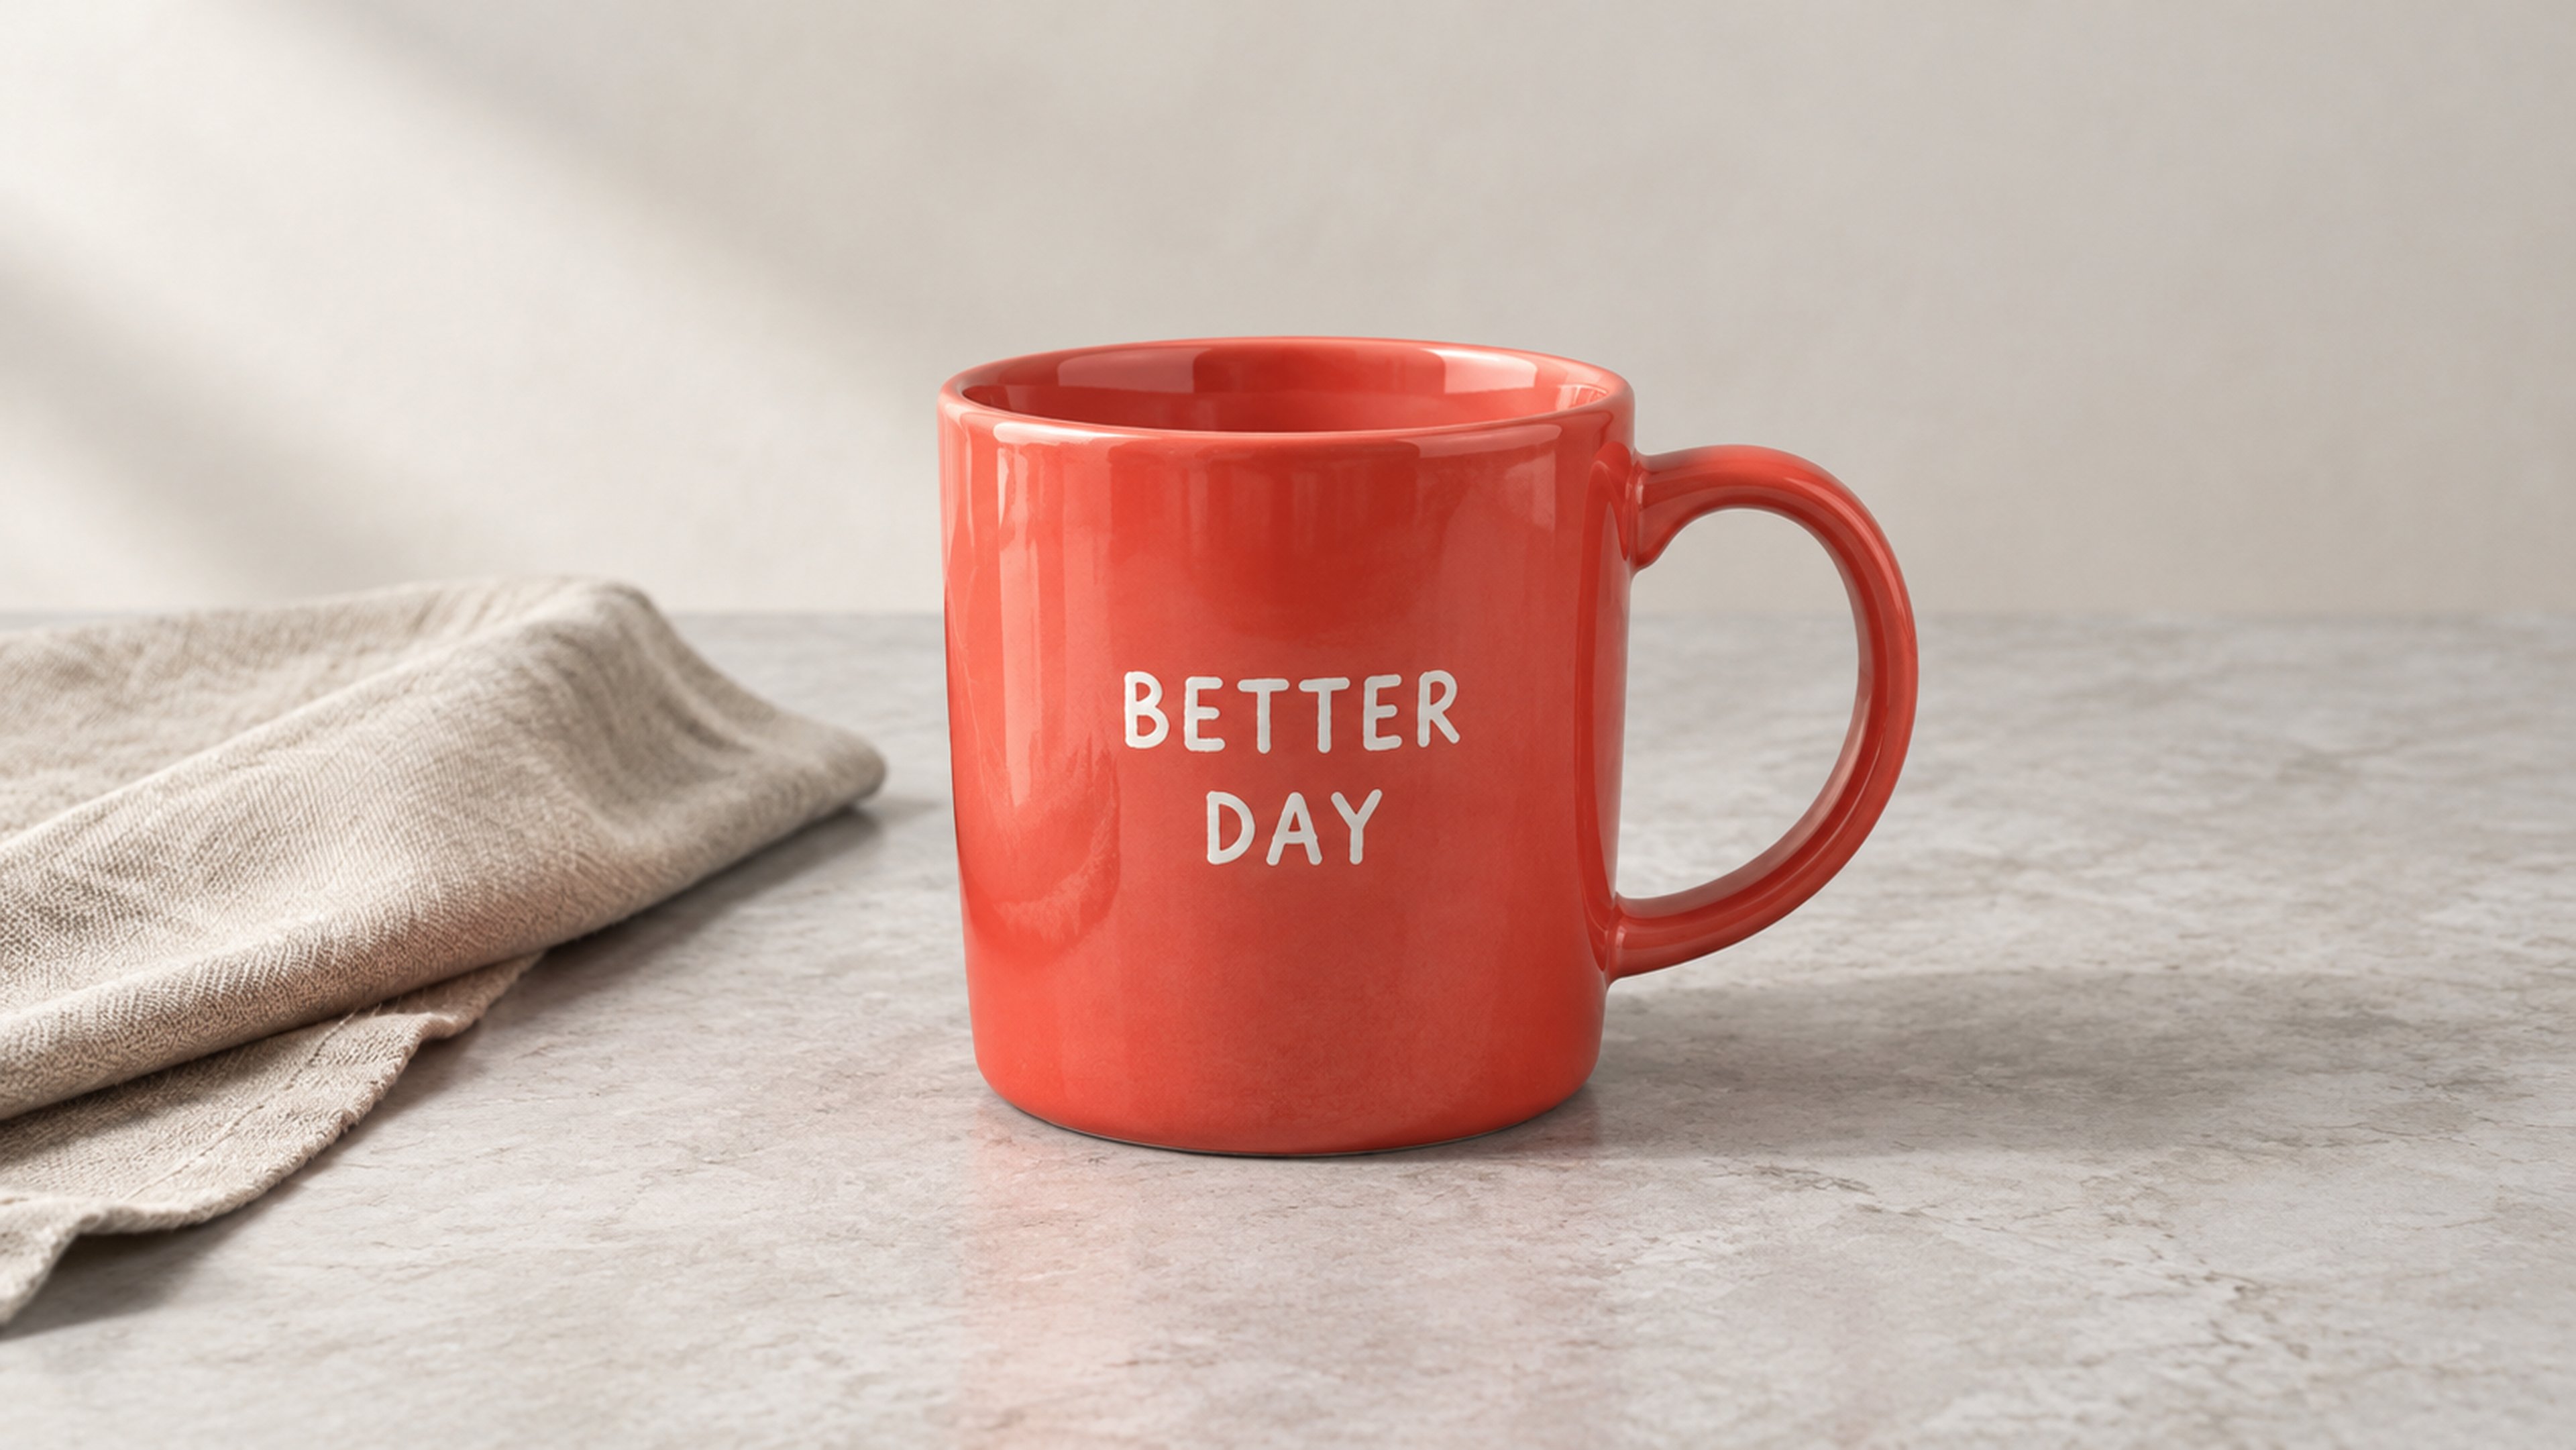
- Imágenes bien acabadas: las tres muestran los reflejos del esmalte rojo coral, el asa a la derecha, la encimera de piedra gris claro, las fibras del paño de lino beige y el texto blanco «BETTER DAY», claramente legible.
- Diferencias entre muestras independientes: cada generación es una muestra independiente, por lo que varían de forma natural la proporción de la taza, el grosor de las letras y la forma de doblar la tela (por ejemplo, en la imagen horizontal 4K el texto aparece en dos líneas). Por eso, los recortes solo muestran los detalles reales de cada imagen; no constituyen un experimento óptico de nitidez con composiciones estrictamente idénticas.
- Límite de facturación visible: aunque en la primera imagen se solicitó
1024x1024, se entregó una imagen cuadrada de alta resolución de1254×1254; por ello, se cobró como nivel 2K (¥0.11), igual que la segunda imagen de2048×2048.
Caso B: cambio de color localizado de un producto; resultados y límites reales de Mask
Usamos como imagen original la primera imagen de producto generada en el caso A (1254×1254) y preparamos una máscara con canal Alpha y las mismas dimensiones mask-mug.png: solo se hizo transparente el polígono del cuerpo de la taza (se permite volver a dibujarlo), mientras que el asa, la pared interior del borde y el fondo se dejaron opacos (se pide conservarlos); el texto de la taza quedó dentro de la zona transparente y se indicó en el prompt que se conservara.
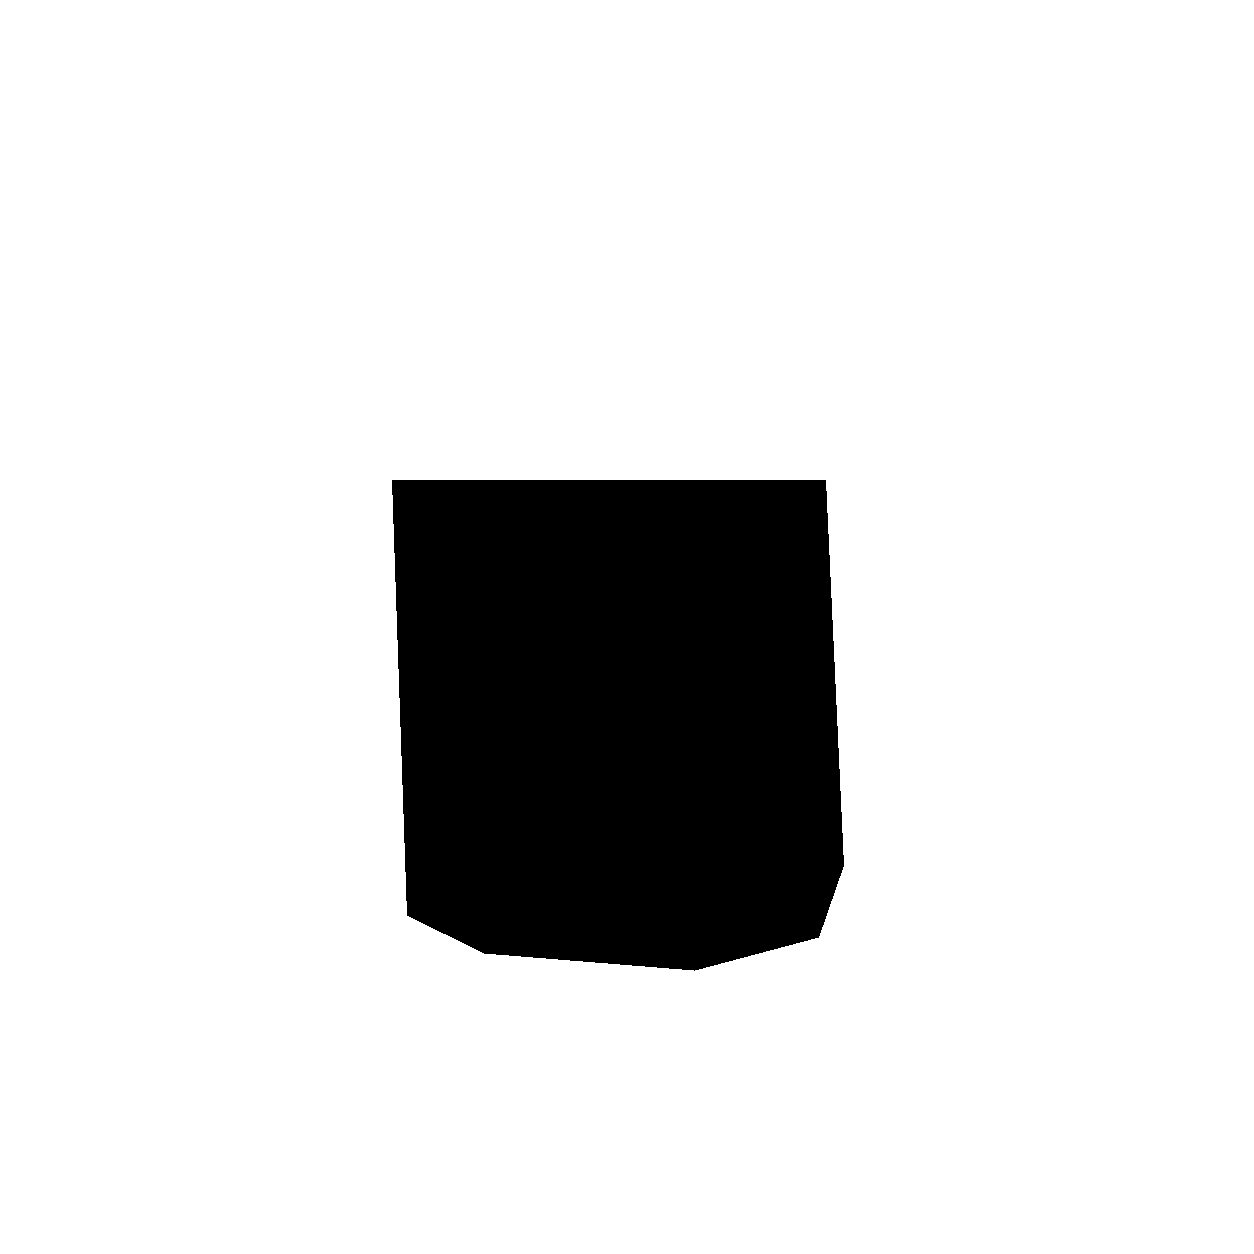
mask-mug.png, con canal de transparencia.)
Diseño de la escena (concepto en chino):
Cambia únicamente el cuerpo rojo coral de la taza dentro de la zona transparente de la máscara a azul marino oscuro. Conserva el material cerámico, la iluminación y los reflejos. Mantén sin cambios las letras blancas «BETTER DAY», el asa roja, el paño de lino, la encimera, el fondo y la composición general. No añadas ni elimines ningún objeto.Prompt real de edición (modelo:
gpt-image-2, size="2048x2048", quality="high"):
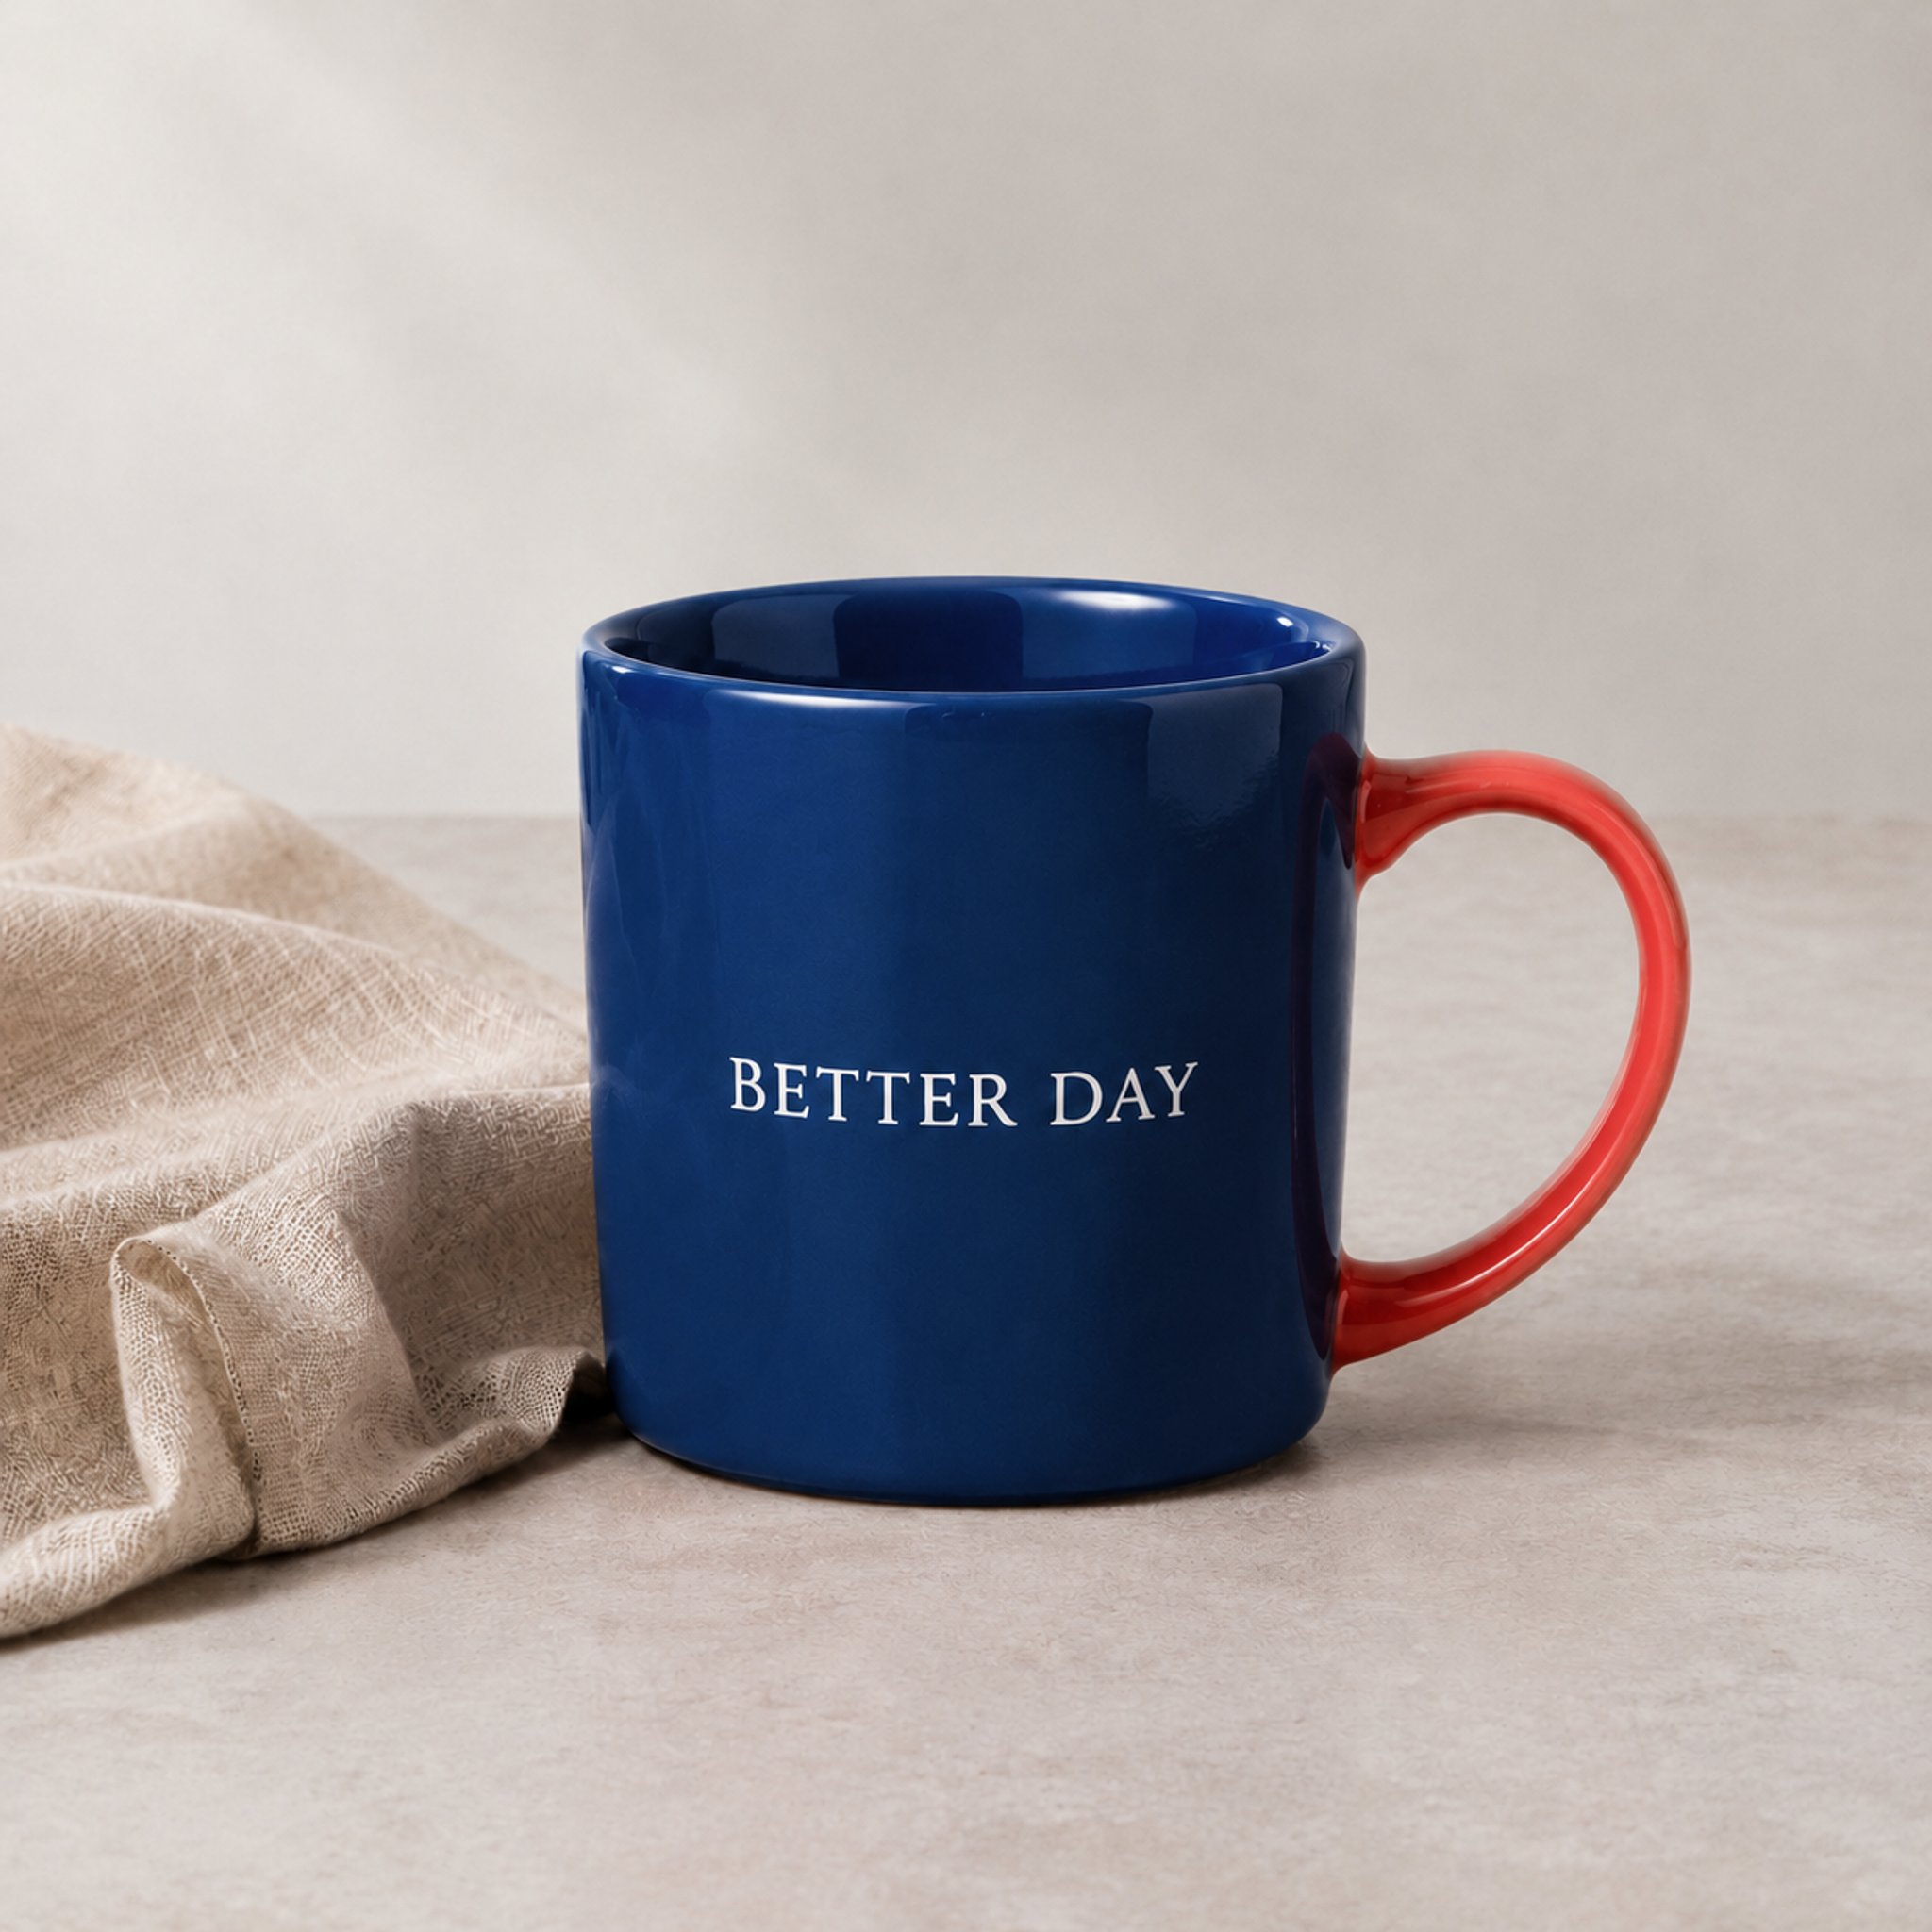
- Se logró el cambio de color principal: el exterior del cuerpo de la taza pasó correctamente a azul marino oscuro y conservó el brillo cerámico; se mantuvieron el asa roja fuera de la máscara, el paño de lino de la izquierda y el fondo, y el texto «BETTER DAY» dentro de la máscara siguió siendo legible.
- El límite estricto de Mask no se superó (hubo filtración fuera de la zona): al observar el borde y la pared interior de la taza, se ve que parte del color rojo coral, originalmente dentro de la zona protegida opaca, también se cambió a azul oscuro. En la prueba geométrica más extrema de «dos círculos», también cambió el círculo derecho que no estaba enmascarado.
- Recomendación de uso: al subir una imagen de referencia y una Mask, asegúrate de que ambas tengan el mismo tamaño de lienzo (la zona que se debe modificar ha de ser transparente y la que se conserva, opaca), e indica en el Prompt tanto «qué cambiar» como «qué conservar». En imágenes comerciales industriales con logotipos de marca, texto pequeño en el envase o requisitos estrictos para los bordes, amplía la imagen después de generarla e inspecciona los límites de la zona protegida.
7. Precios y coste real de uso: ¿cuánto se cobra al final?
BetterToken mantiene precios transparentes. Estos son los precios públicos del 19 de octubre de 2026 (CNY se aplica a las cuentas empresariales en renminbi y USD a las cuentas normales en dólares; son precios independientes y no se convierten con el tipo de cambio en tiempo real):
Según los precios públicos anteriores, el coste de referencia para 100 llamadas es el siguiente, suponiendo que las 100 imágenes entregadas correspondan realmente al nivel de facturación indicado (estimación aritmética):
💡 Punto clave para planificar el presupuesto: calcula el coste según el «nivel realmente entregado», no según los «parámetros solicitados». Como muestran las pruebas anteriores, hoy algunas solicitudes aflare,sunburstogpt-image-2con1024x1024(1K) entregaron imágenes de1254×1254. En ese caso, el sistema las clasifica según el resultado real como 2K (es decir, cobra ¥0.15 o ¥0.11, no el precio 1K de ¥0.035). Si las 100 solicitudes de1024x1024aflaredevolvieran1254×1254, al precio actual el coste de las 100 imágenes sería ¥15.00 (estimación aritmética). Además, la lógica de clasificación combina el tamaño objetivo con un umbral de desviación razonable (por ejemplo,3840×2159se clasifica normalmente como 4K y1536×1024como 1K). No recalcules el coste en tu aplicación con una regla simplista como «si el lado más largo supera 1024»; la liquidación siempre se determina según el campobettertoken_image_billingdel cuerpo de la respuesta.
¿Por qué no basta con fijarse en el «precio bajo por imagen»?
Al comparar los costes de las API de imágenes de distintas plataformas, te conviene hacer bien estas tres cuentas:- El precio solo es comparable si el tamaño real de la respuesta alcanza el objetivo: una solicitud que anuncia «compatibilidad con 4K a un precio muy bajo», pero solo devuelve una imagen reducida de 1024, no puede utilizarse en un entorno de producción que necesite imágenes de alta resolución y no debe compararse como un precio 4K válido.
- Incluye en el total los fallos y el coste de volver a generar: las pruebas de parámetros no válidos de esta ronda no tuvieron coste; si una imagen se entregó correctamente pero no satisface tus necesidades, volver a enviarla es una nueva solicitud y debe presupuestarse por separado. Las 4 imágenes de los casos de producto y Mask de esta guía (3 generadas + 1 editada) se entregaron con una solicitud cada una. La muestra de Mask tuvo el cambio de color fuera de la zona explicado arriba. Sus precios individuales fueron ¥0.11, ¥0.11, ¥0.13 y ¥0.11, con un coste real total de solo ¥0.46 por las 4 imágenes; la factura coincidió exactamente con los cargos de la cuenta. Si una ruta inestable o parámetros incompatibles te obligan a repetir las generaciones, el coste real de obtener un recurso utilizable puede aumentar aunque el precio anunciado por imagen sea bajo.
- Reduce el coste oculto de adaptación para el equipo de desarrollo: BetterToken unifica la normalización de parámetros, enruta según las capacidades y devuelve en tiempo real los píxeles reales y los campos de facturación, reduciendo el trabajo de adaptar cada servicio y organizar por separado las dimensiones y los costes.
8. Ejemplos de llamadas listos para copiar
Guarda tu BetterToken API Key en la variable de entornoBETTERTOKEN_API_KEY y podrás copiar directamente los siguientes comandos para empezar a realizar llamadas.
Ejemplo 1: solicitud JSON para generar una imagen de producto de alta resolución (POST /v1/images/generations)
El ejemplo llama a gpt-image-2 para generar una imagen de producto de alta resolución de 2048x2048 (model se puede sustituir directamente por gpt-image-2.5-flare o gpt-image-2.5-sunburst):
- Nota sobre las dimensiones: para una imagen horizontal 4K, cambia
"size"por"3840x2160"(no uses"4096x4096"). Las dimensiones válidas actuales deben cumplir lo siguiente: ancho y alto múltiplos de 16, lado más largo no superior a 3840, relación entre lado largo y corto no superior a 3:1 y un total de entre655,360y8,294,400píxeles. - Nota sobre la identificación del formato de archivo: aunque la solicitud especifique
"output_format": "png", algunos nodos subyacentes pueden devolver contenido binario en formato JPEG. Al guardar o procesar la imagen, conviene identificar el formato real según la cabecera del archivo (Magic Bytes) y no fijar la extensión por adelantado.
Ejemplo 2: edición localizada con imagen de referencia y Mask en Multipart (POST /v1/images/edits)
Prepara la imagen original product-1k-0.png y la máscara transparente del mismo tamaño mask-mug.png (si solo necesitas editar una imagen de referencia normal, elimina directamente la línea -F "mask=..."):
Ejemplo 3: lectura de los píxeles realmente entregados y los datos de facturación (estructura de respuesta y código de análisis)
Además dedata[].b64_json, el cuerpo de respuesta de BetterToken incluye el nodo del campo ampliado bettertoken_image_billing:
Referencias: