gpt-image-2, gpt-image-2.5-flare et gpt-image-2.5-sunburst, les développeurs rencontrent souvent plusieurs questions épineuses :
- Pourquoi les résultats diffèrent-ils d’un appel à l’autre avec le même modèle et les mêmes paramètres ?
- Pourquoi l’image reçue est-elle réduite à 1K alors que j’ai demandé 4K ou une dimension précise ?
- La retouche locale avec
Maskouquality=higha-t-elle réellement fonctionné ? Selon quel critère la facturation finale est-elle calculée ?
200 OK est loin de suffire : trois conditions doivent être réunies en même temps : obtenir une image, pouvoir l’utiliser dans la mise en page prévue et disposer de coûts transparents et prévisibles.
Pour aider les développeurs à comprendre le comportement réel de ces trois modèles, BetterToken a mis en place au niveau inférieur un routage intelligent selon les capacités, le nettoyage des paramètres par défaut, le blocage préalable des paramètres invalides et une facturation transparente fondée sur les pixels réellement livrés. Ce guide s’appuie sur les résultats des tests les plus récents et sur un instantané des tarifs du 19 octobre 2026. À partir d’images originales générées et de factures réelles, il montre comment effectuer les appels, quels résultats obtenir et quelles limites objectives subsistent pour les modèles eux-mêmes.
Remarque : ce guide porte surgpt-image-2,gpt-image-2.5-flareetgpt-image-2.5-sunburst. Les paramètres et la facturation de la série Nano Banana sont différents ; ils feront l’objet d’un autre article afin d’éviter toute confusion.
1. Pourquoi les résultats peuvent-ils varier avec le même modèle et les mêmes paramètres ?
En pratique, les différents nœuds de service derrière un même nom de modèle présentent souvent des capacités et une stabilité différentes : certaines routes ne prennent en charge que la génération de base en 1K, tandis que d’autres livrent des images haute définition en2048×2048 ou même en 3840×2160. La prise en charge des valeurs de quality, de la retouche à partir d’une image de référence et des masques Mask varie également selon les nœuds.
Si la plateforme se contente de transférer aveuglément les requêtes selon le nom du modèle, les développeurs rencontrent souvent des situations comme « j’ai demandé 4K, mais j’ai reçu une petite image 1K », « j’ai envoyé une Mask et l’appel a échoué » ou « je dois ajuster les paramètres encore et encore ». C’est pourquoi il faut un protocole de test rigoureux qui vérifie séparément l’acceptation des paramètres par l’interface et le résultat réellement livré.
2. Notre méthode de test : que signifie « pris en charge » ?
Pour garantir des conclusions objectives et fiables, nous avons conçu 22 scénarios de test standard pour la régression de la version stable (17 requêtes valides ont livré 18 images ; les 5 scénarios comportant des paramètres invalides ont été bloqués comme prévu et n’ont pas été facturés). Nous avons également généré des images de produits et des exemples d’édition avec Mask pour des usages fréquents du commerce en ligne. Nos critères de vérification sont directs :- Décoder les pixels du fichier original : nous ne nous fions pas à la seule déclaration de l’API. Nous décodons les dimensions de chaque image livrée à partir du fichier d’origine, puis nous les comparons au niveau de facturation indiqué dans la réponse et au débit réel du compte.
- Vérifier que les dimensions sont atteintes : nous comparons séparément la largeur et la hauteur explicitement demandées. Une dimension réelle supérieure est considérée comme conforme ; si l’un des côtés est inférieur de plus de 5% à la dimension cible, le résultat n’est pas conforme (remarque : ce critère sert à évaluer rigoureusement les résultats du test ; cela ne signifie pas que l’API rejette automatiquement les images valides qui n’atteignent pas la dimension demandée). Si la dimension est omise ou que
autoest transmis, aucun canevas fixe n’est défini comme objectif. - Distinguer l’acceptation des paramètres du résultat réel : l’absence d’erreur signifie seulement que « le paramètre a été accepté ». Pour savoir si
Maskisole strictement une zone ou siquality=highapporte un gain visuel, il faut examiner l’image finale.
3. Résultats des tests : quels paramètres sont le plus souvent mal compris ?
En comparant les paramètres de requête, les pixels réellement livrés et la facture finale, nous avons relevé plusieurs faits clés que les développeurs interprètent souvent mal :
Les tests ont également révélé les comportements suivants concernant la compatibilité des paramètres et la gestion des erreurs :
- Tolérance aux paramètres par défaut : la génération fonctionne normalement si
qualityetsizesont omis, transmis commenullou explicitement définis sur"auto". - Comment demander correctement du 4K : « 4K » désigne un niveau de facturation et ne signifie pas que les images carrées
4096x4096sont prises en charge. Pour une grande image horizontale de niveau 4K, utilisez3840x2160. - Blocage des paramètres invalides sans frais : les requêtes de test envoyant
4096x4096,stream=true, une chaîne videquality="", une chaîne videsize=""oun=0ont toutes renvoyé une erreurHTTP 400et n’ont généré aucun frais.
4. Ce que propose BetterToken : pas besoin d’adapter chaque route
Face aux variations de dimensions et aux différences entre les nœuds des modèles sous-jacents, BetterToken prend en charge quatre aspects au niveau de la passerelle afin que vous n’ayez pas à écrire un code d’adaptation pour chaque route :- Routage intelligent selon les capacités : le système sélectionne automatiquement un service disponible doté des capacités correspondantes selon le modèle transmis, la dimension cible (par exemple 2K/4K) et la présence de paramètres d’édition d’image ou de
Mask. - Interface unifiée et valeurs de repli pour les paramètres : les interfaces standard
POST /v1/images/generations(génération d’image) etPOST /v1/images/edits(édition à partir d’une image de référence/Mask) traitent automatiquementnull,autoet les paramètres omis, et bloquent les entrées invalides au niveau de la passerelle. - Retour transparent des dimensions réelles et du détail de facturation : en plus des données d’image, le champ
bettertoken_image_billingdu corps de réponse indique directement la largeur et la hauteur décodées réelles (width/height), le niveau de facturation (billing_resolution), la devise et le montant réglé (settled_amount). - Distinction claire entre deux notions essentielles :
- La prise en charge du paramètre
Mask≠ une retouche précise au pixel près : l’interface permet de charger une image de référence et une Mask pour effectuer une édition, mais certains résultats de test ont également modifié des zones protégées à l’extérieur du masque. Par exemple, lors de notre test géométrique des deux cercles, le cercle gauche transparent devait changer de couleur et le cercle droit opaque devait être protégé ; les deux cercles ont finalement changé de couleur. Ainsi, nous confirmons la prise en charge du paramètre Mask, mais ne garantissons pas un isolement strict au pixel près à chaque appel. - La prise en charge du paramètre
quality≠ une amélioration de qualité garantie et fixe : l’interface accepte des valeurs comme"auto"ou"high"et les route correctement. Toutefois, la génération étant aléatoire, nous ne promettons pas, sur la base d’un seul échantillon, quehighproduira une amélioration d’un pourcentage donné.
- La prise en charge du paramètre
⚠️ Deux limites réelles à connaître avant l’intégration :
- Le routage par capacité ne garantit pas un nombre de pixels strictement fixe à chaque appel : en raison des différences de sortie des services sous-jacents, les pixels peuvent varier même si la requête est dirigée vers le bon nœud (par exemple, certaines requêtes
1024x1024ont aujourd’hui renvoyé1024×936et certains échantillons demandant3840x2160ont renvoyé3840×2161). Si le rapport du canevas est essentiel à votre activité, utilisez les dimensions réelles renvoyées pour recadrer ou post-traiter l’image.- Demander du 1K ne signifie pas nécessairement payer le tarif 1K : le système classe l’image selon les dimensions valides réellement livrées. Aujourd’hui, les deux modèles 2.5 (et certains cas de
gpt-image-2) ont renvoyé1254×1254pour des demandes1024x1024; le système les a donc classées au niveau 2K et a appliqué le tarif correspondant.
5. Prise en charge des trois modèles : lequel appeler et quelles valeurs transmettre ?
La configuration des capacités et la couverture actuelle des tests degpt-image-2, gpt-image-2.5-flare et gpt-image-2.5-sunburst sont les suivantes :
Remarque : « testé lors de cette série » signifie que les régressions et les exemples générés aujourd’hui ont directement livré des images et des exemples de facturation. « Configuration de routage alignée pour la prise en charge » signifie que la plateforme a aligné la configuration du canal pour la capacité concernée, mais n’a pas répété aujourd’hui les appels pour toutes les combinaisons possibles.
6. Deux exemples d’images réelles : quels sont les résultats ?
Pour montrer le niveau de génération le plus réaliste possible, nous avons suivi la structure « sujet explicite + texture du matériau + direction de la lumière + proportions de la composition + éléments à exclure » du guide officiel d’OpenAI sur les prompts d’image et généré les deux exemples de commerce en ligne ci-dessous avec l’interface réelle de BetterToken (les sorties originales sont conservées, sans retouche ultérieure).Exemple A : photographie de produit pour le commerce en ligne, dimensions et détails en 1K / 2K / 4K
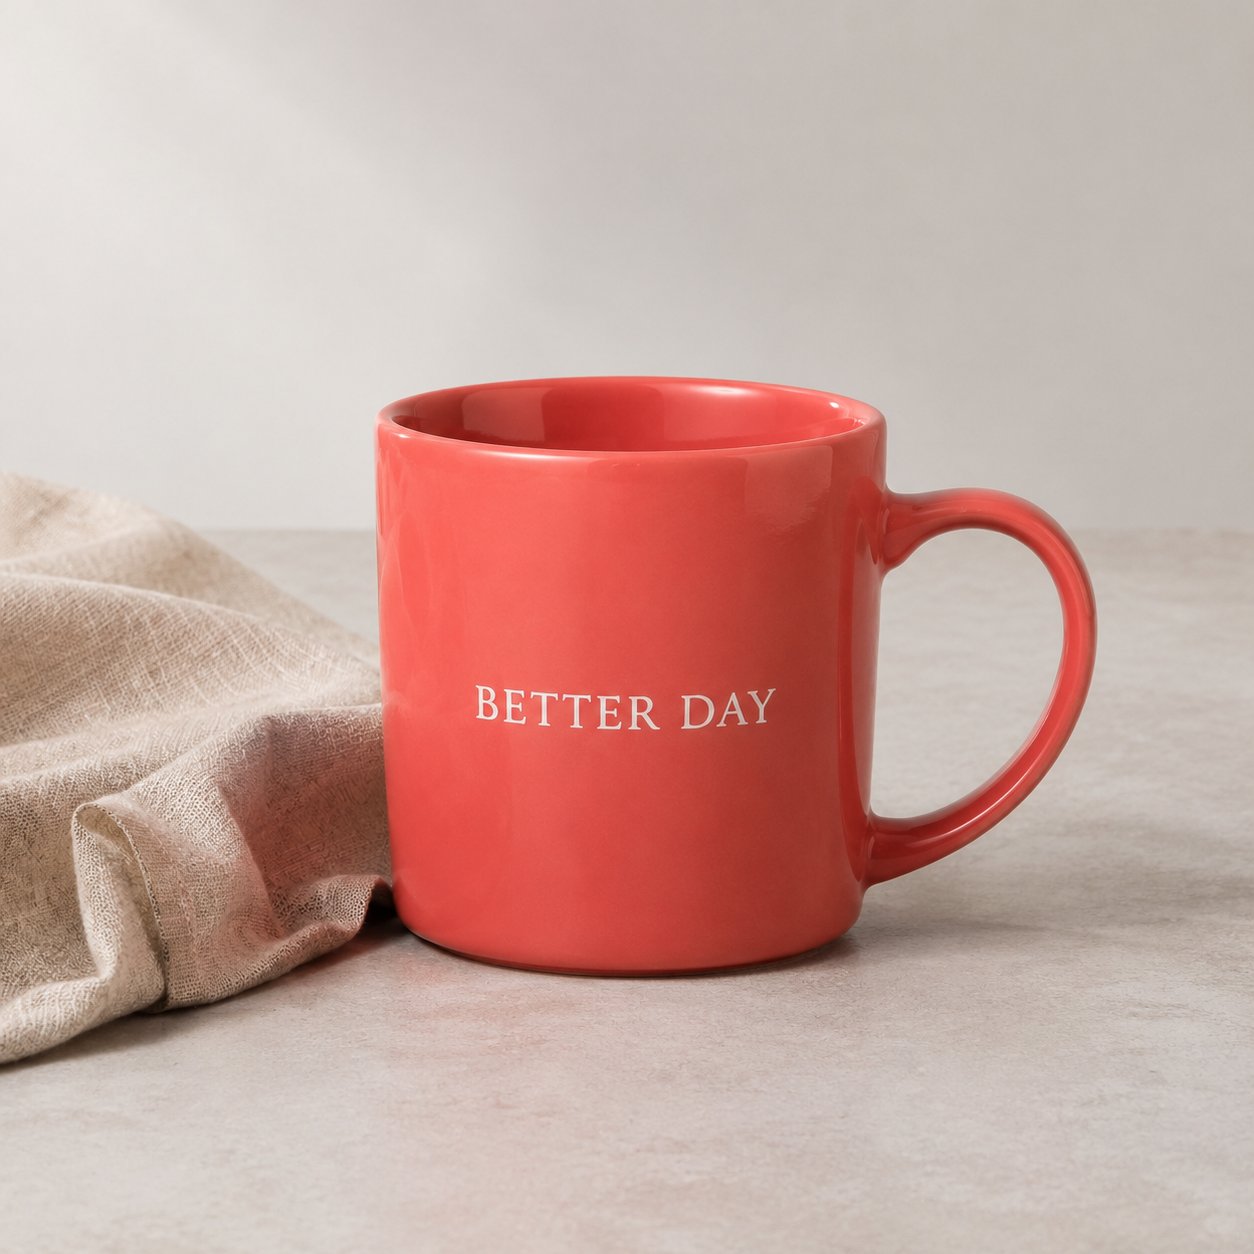
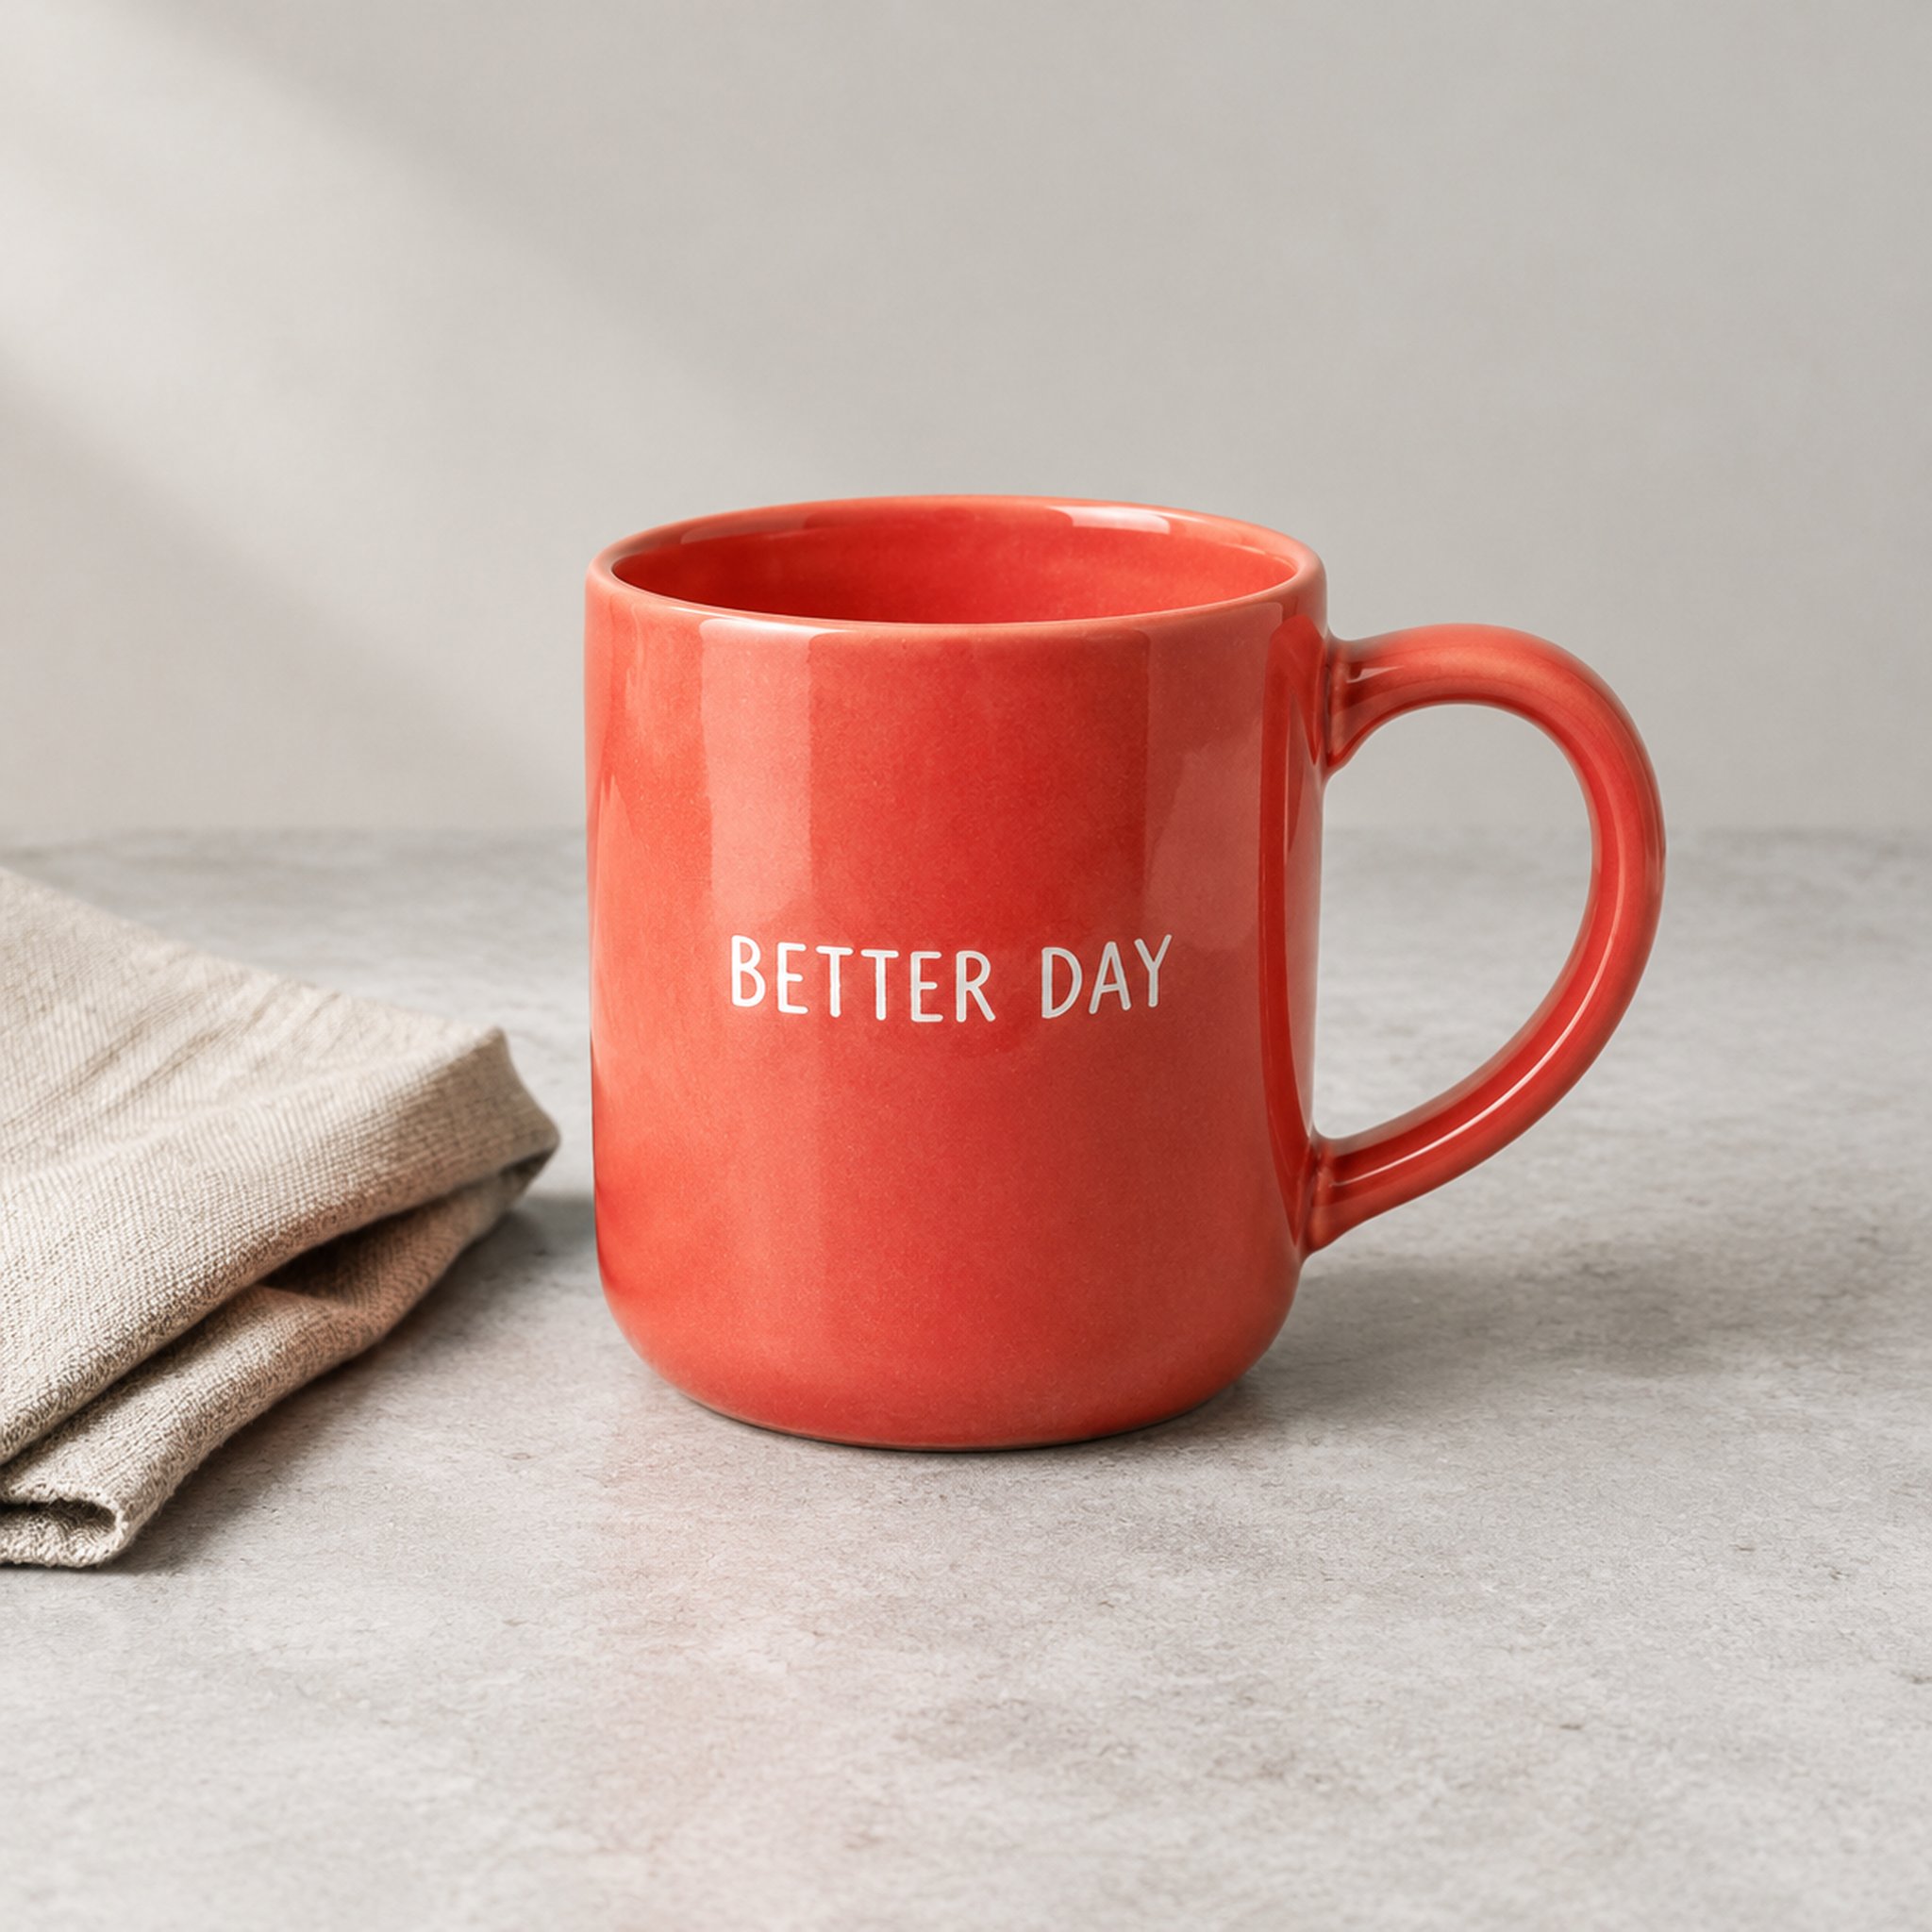
Description de la scène (conception originale en chinois) :Générer une véritable photo de studio pour le commerce en ligne : un mug en céramique rouge corail (anse orientée vers la droite) posé sur un plan de travail en pierre gris clair, avec un linge en lin beige plié à gauche. Le mug porte le texte blanc bien net « BETTER DAY ». Lumière latérale douce venant du haut à gauche ; conserver les reflets subtils de l’émail céramique, les fibres du lin et les ombres de contact naturelles. Le mug est entièrement visible et centré ; arrière-plan neutre et simple, sans autres objets, filigrane ni texte supplémentaire.Prompt réel envoyé en anglais :
gpt-image-2 (quality="high", 1 image par génération), conservé exactement le même Prompt et demandé trois dimensions différentes uniquement via le paramètre size, sans ajouter « 4K » au prompt pour forcer le résultat :
1. Image originale livrée pour la demande
1024x1024 (retour réel de 1254×1254) :
2048x2048 (retour réel de 2048×2048) :
3840x2160 (retour réel de 3840×2161) :
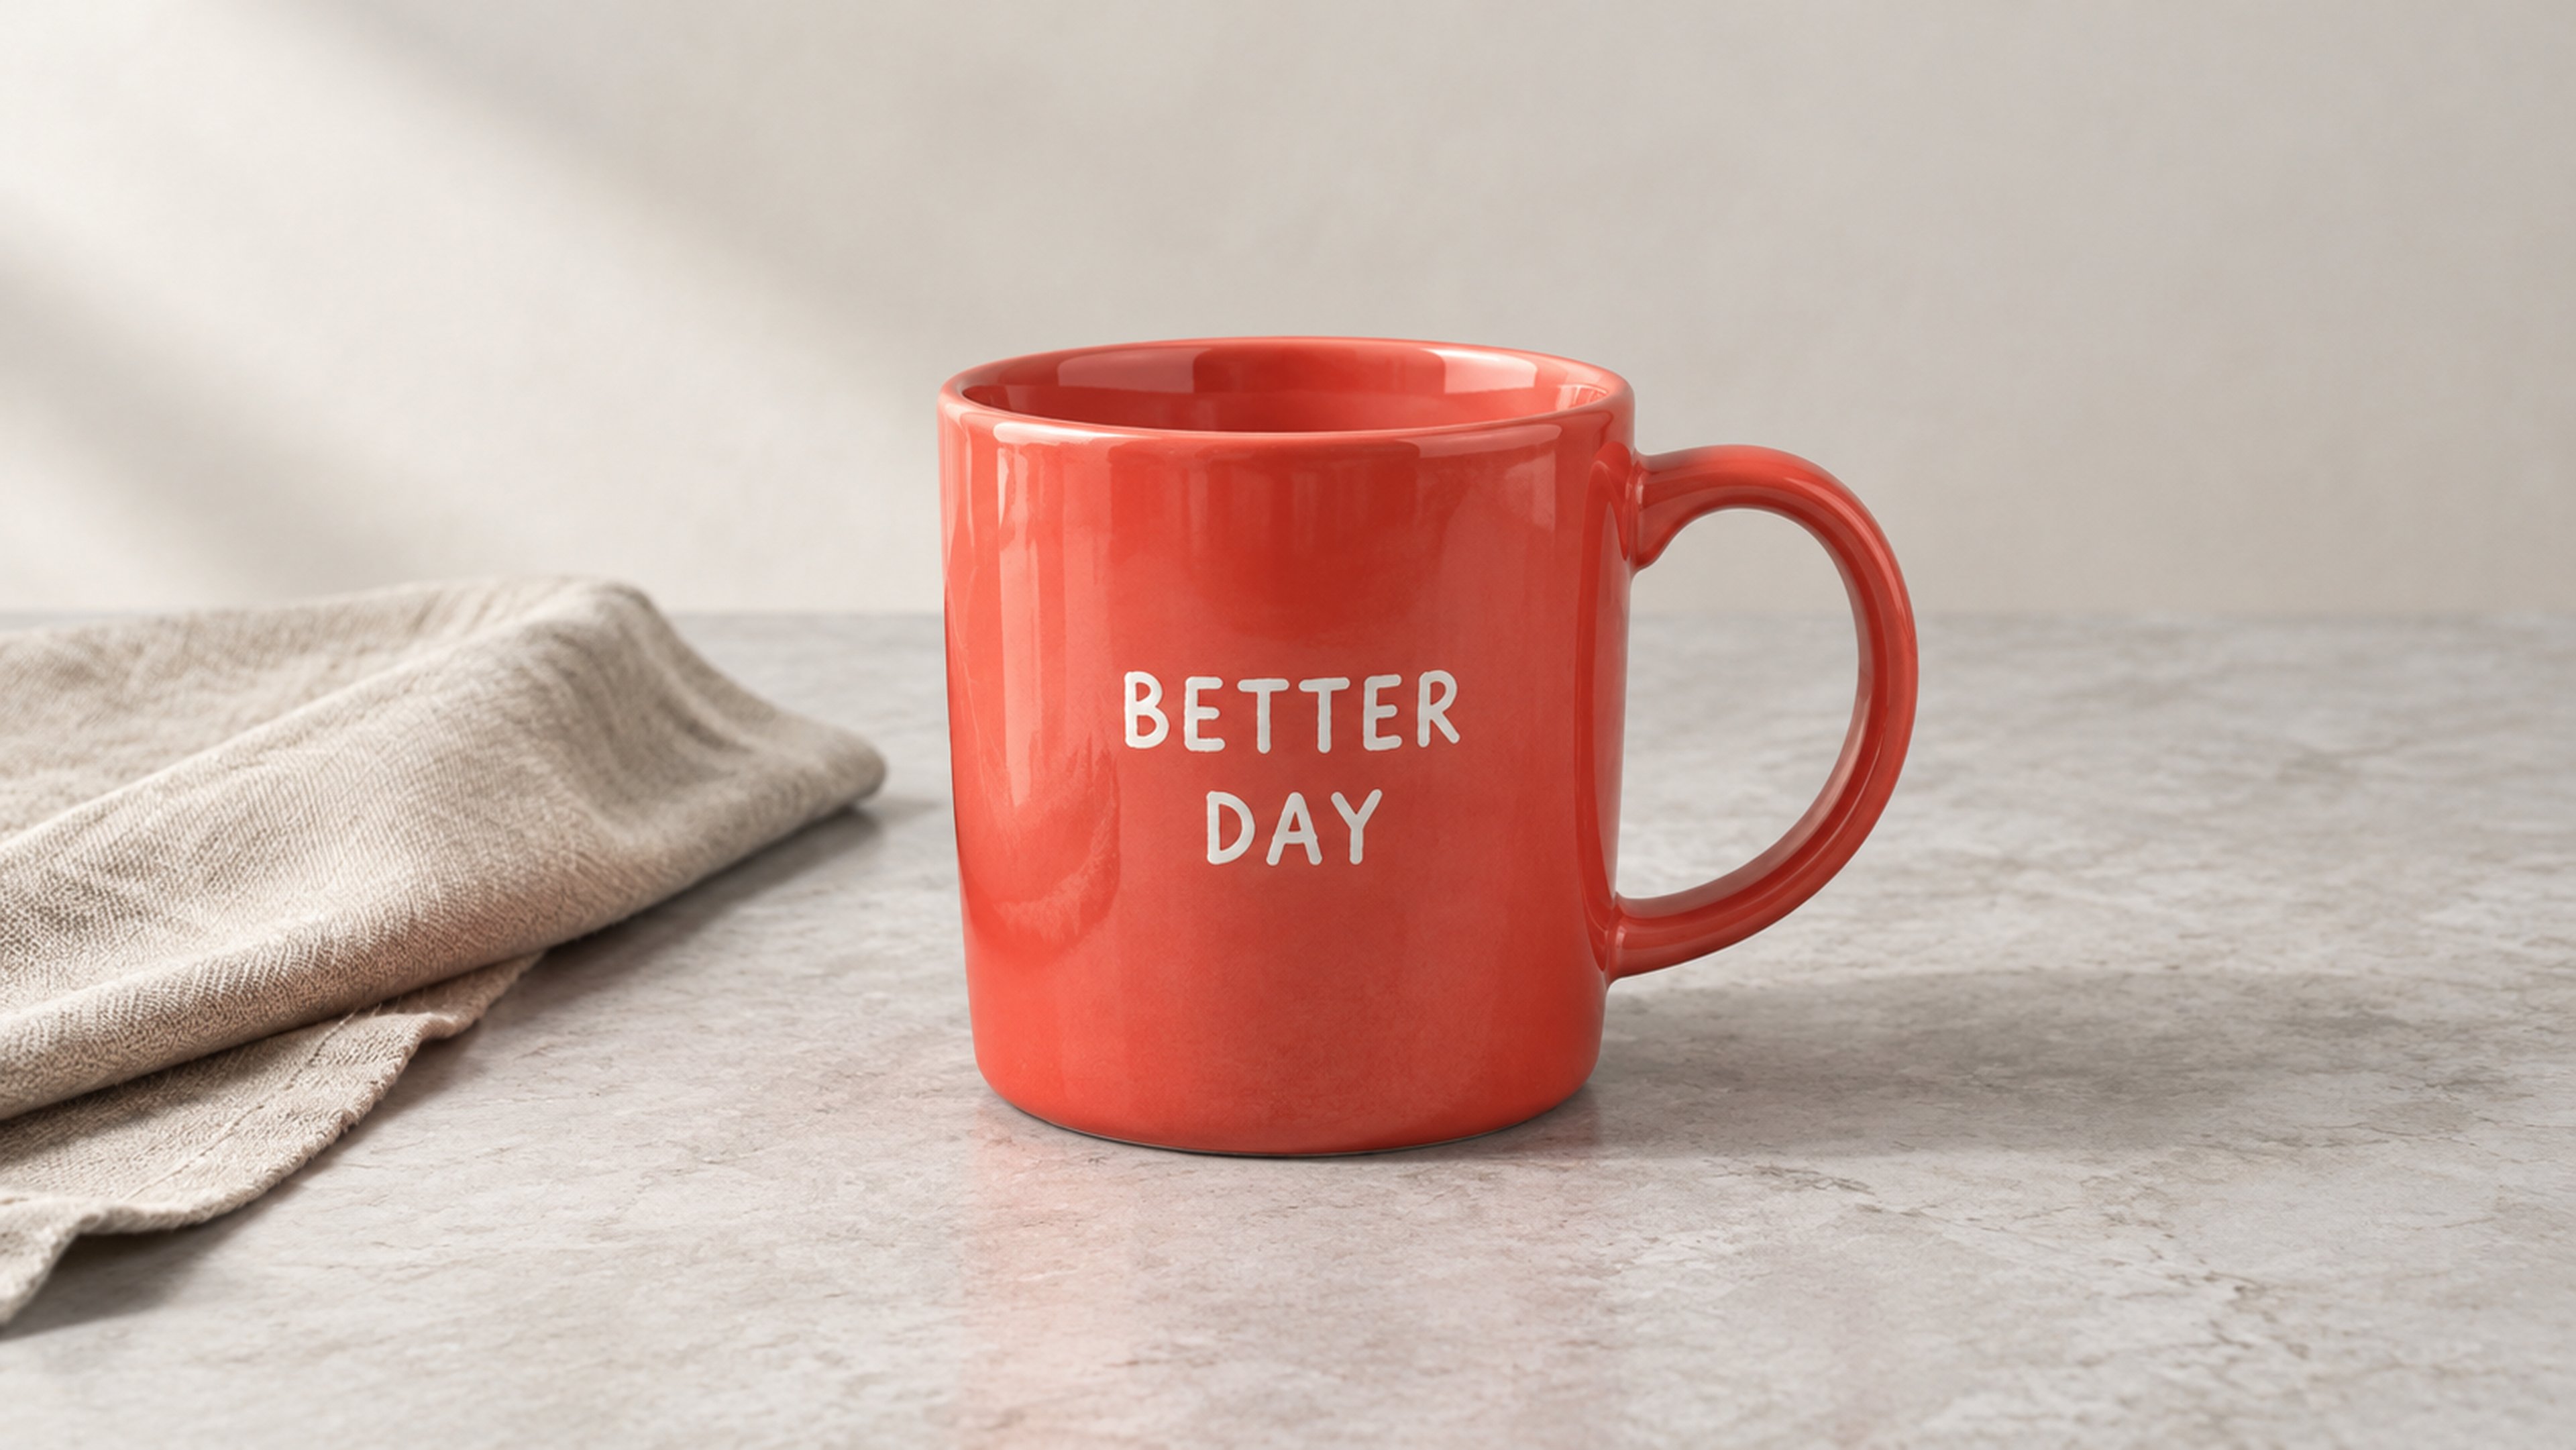
- Rendu soigné : les trois images montrent les reflets de l’émail rouge corail, l’anse à droite, le plan de travail en pierre gris clair, les fibres du linge en lin beige et le texte blanc « BETTER DAY » bien lisible.
- Différences entre échantillons indépendants : chaque génération est un échantillon indépendant ; les proportions du mug, l’épaisseur de la police et le pliage du tissu varient naturellement (par exemple, le texte est disposé sur deux lignes dans l’image horizontale 4K). Les recadrages montrent donc les détails réels de chaque image et ne constituent pas une expérience optique de netteté avec une composition strictement identique.
- Limite de facturation illustrée directement : bien que la première image ait été demandée en
1024x1024, elle a été livrée en image carrée haute définition1254×1254et facturée au niveau 2K (¥0.11), comme la deuxième image en2048×2048.
Exemple B : changement local de couleur d’un produit, résultat réel et limites de Mask
Nous avons utilisé comme image d’origine la première image du produit de l’exemple A (1254×1254) et créé un masque avec canal Alpha de mêmes dimensions mask-mug.png : seul le polygone du corps du mug est transparent (retouche autorisée), tandis que l’anse, la paroi intérieure du bord et l’arrière-plan restent opaques (à préserver) ; le texte du mug se trouve dans la zone transparente et le prompt demande de le conserver.
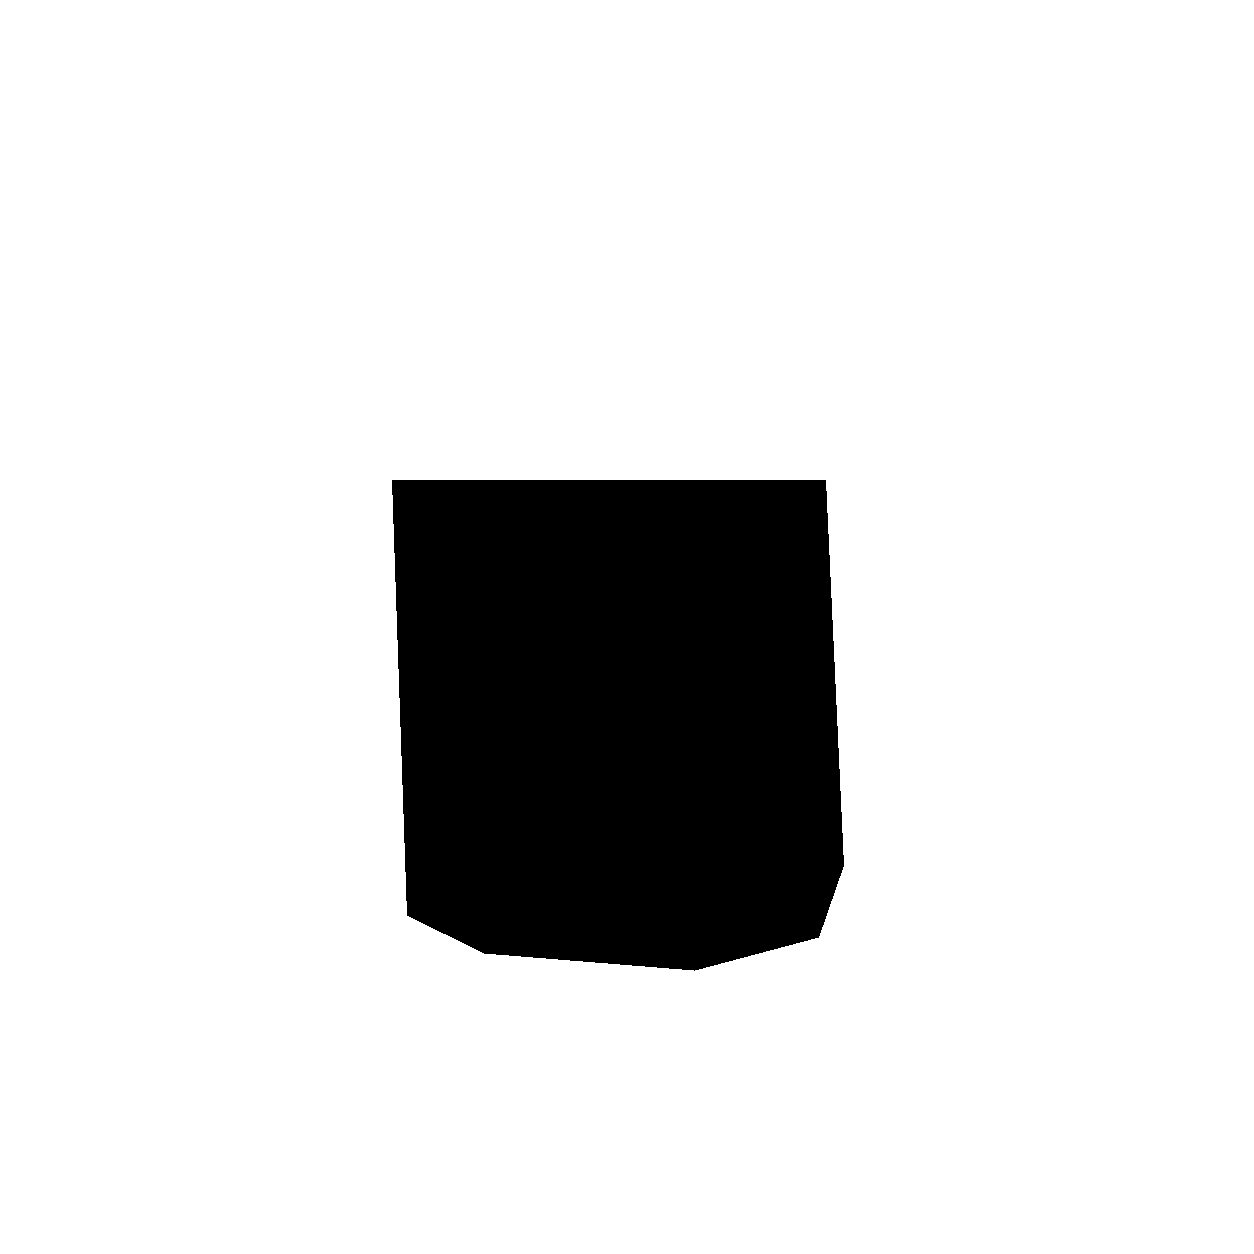
mask-mug.png, doté d’un canal de transparence.)
Description de la scène (conception originale en chinois) :
Remplacer uniquement le corps rouge corail du mug dans la zone transparente du masque par un bleu marine foncé. Préserver la matière céramique, l’éclairage et les reflets. Garder inchangés le texte blanc « BETTER DAY », l’anse rouge, le linge en lin, le plan de travail, l’arrière-plan et la composition générale. N’ajouter ni supprimer aucun objet.Prompt réel de retouche (modèle :
gpt-image-2, size="2048x2048", quality="high") :
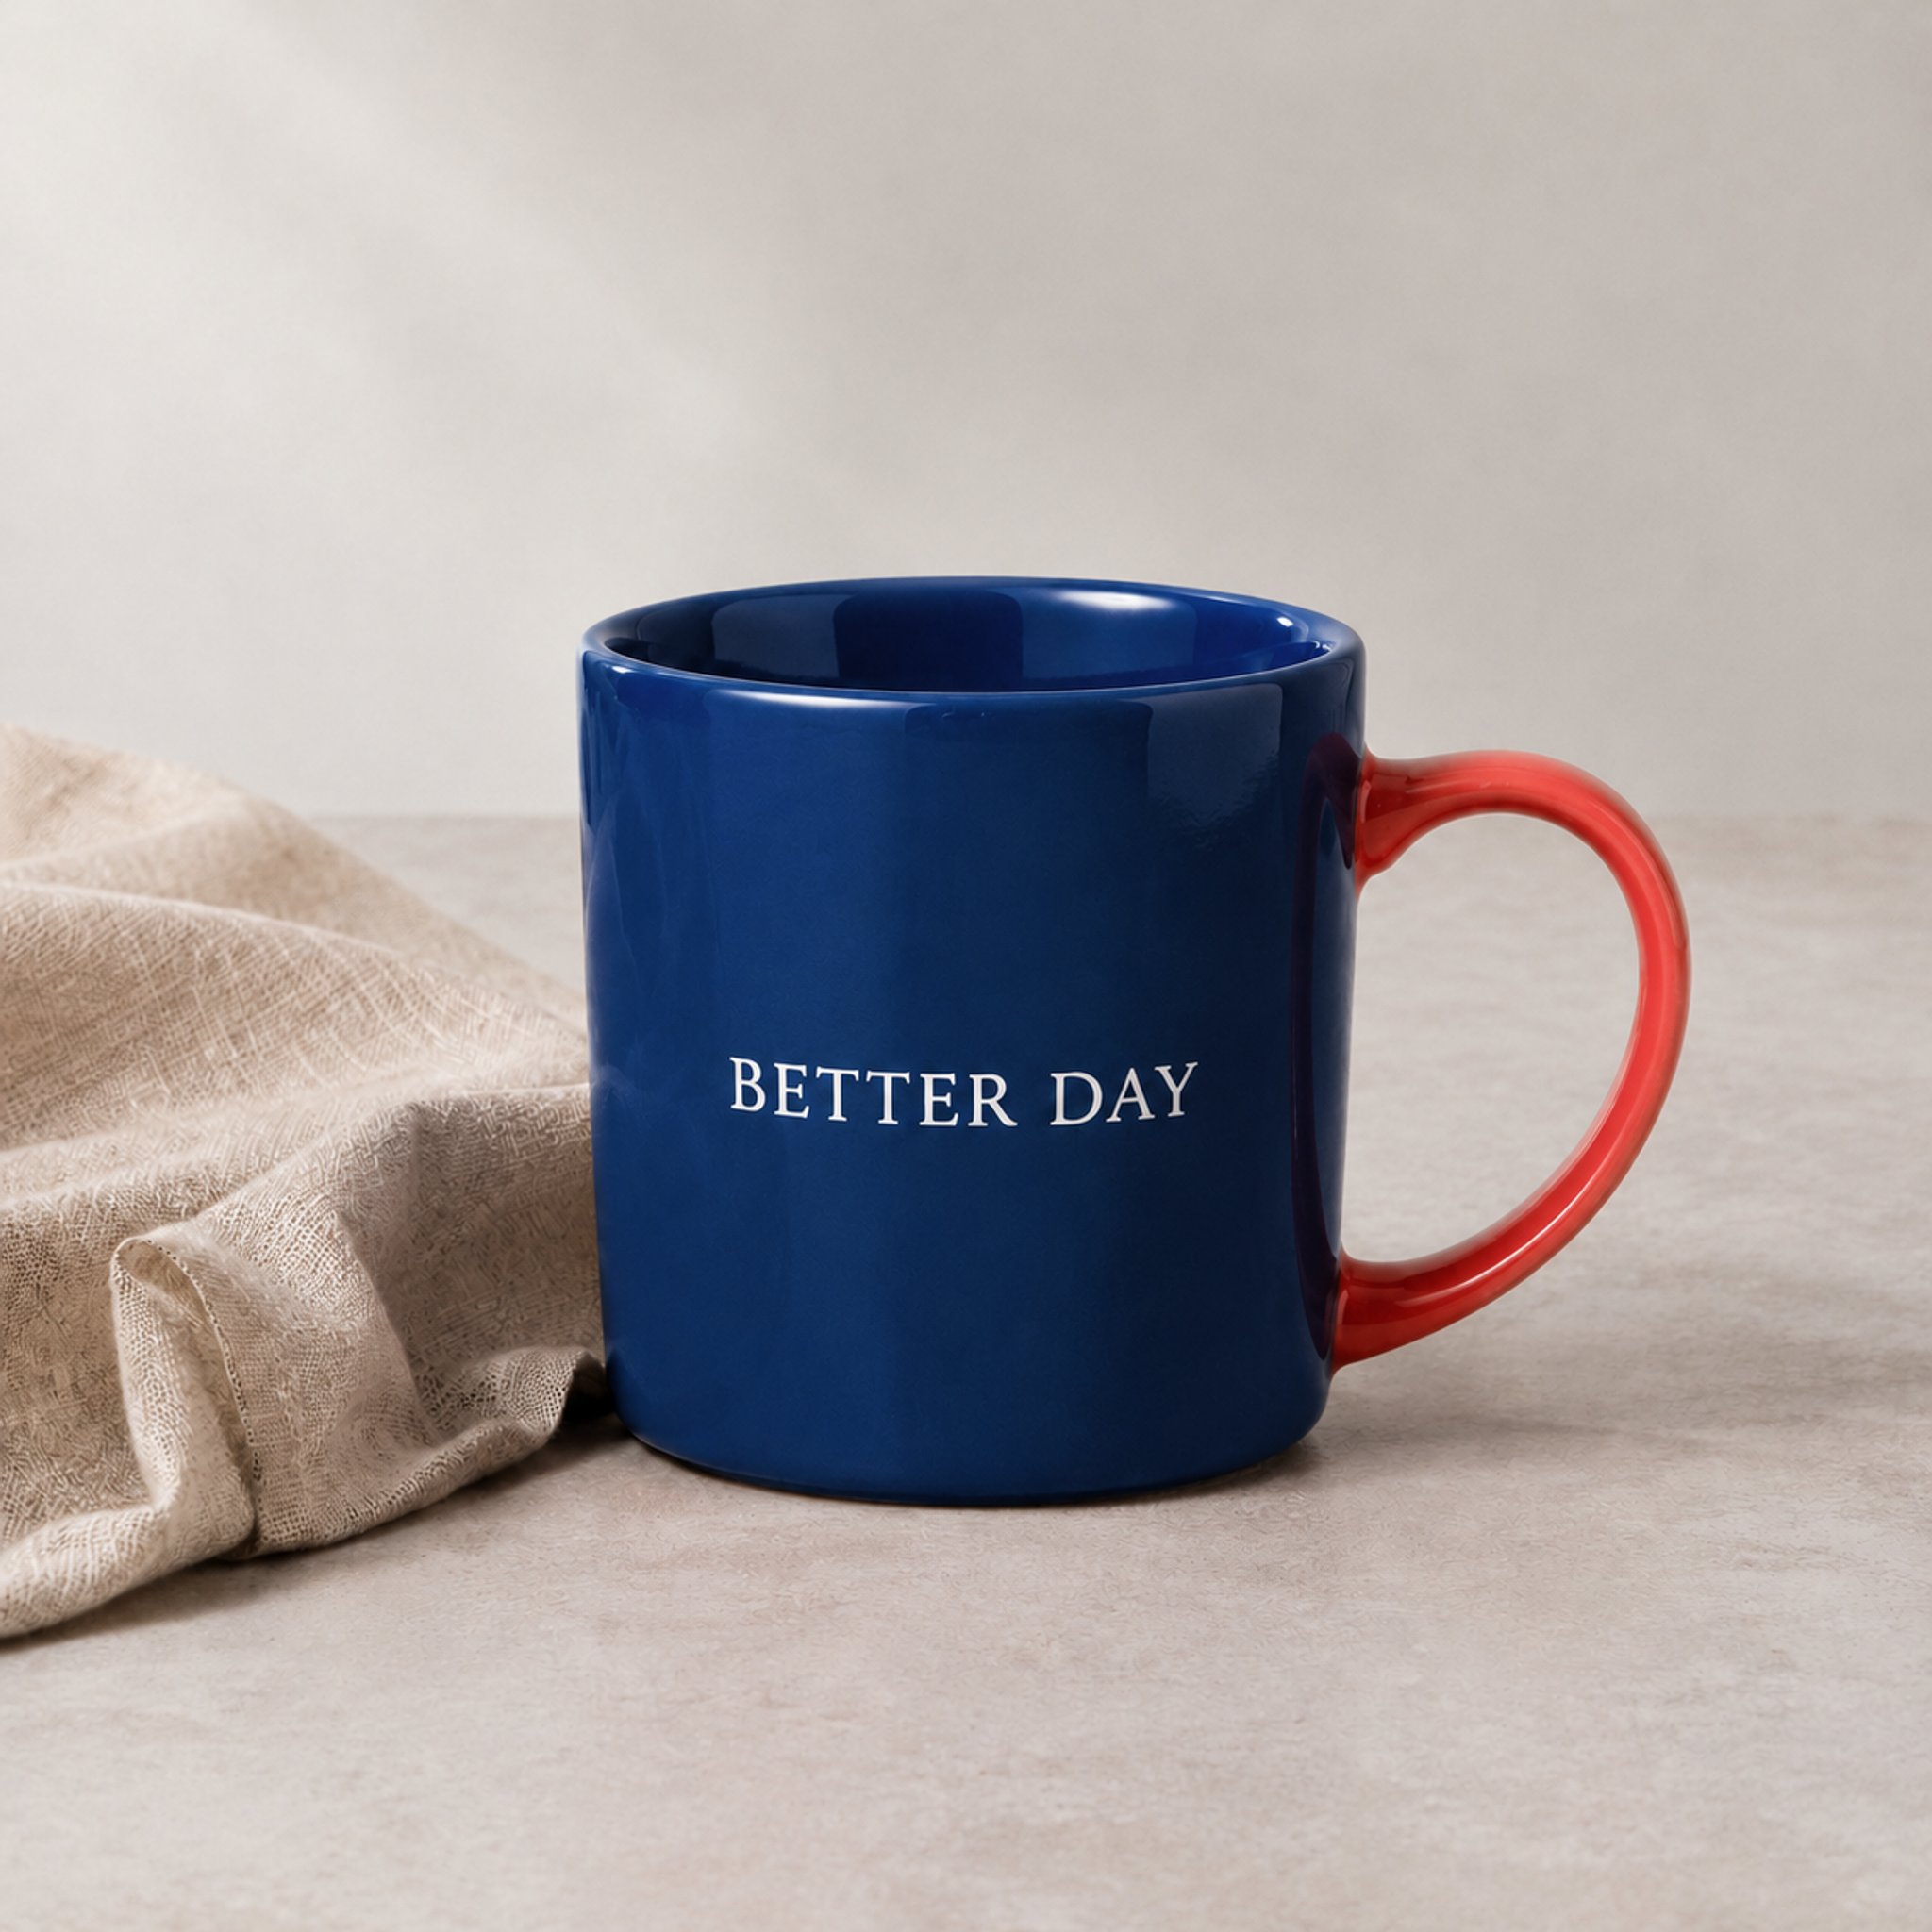
- L’objectif principal de recoloration est atteint : le corps extérieur du mug devient bleu marine foncé et conserve son éclat céramique ; l’anse rouge hors masque, le linge en lin à gauche et l’arrière-plan sont préservés, et le texte « BETTER DAY » dans le masque reste lisible.
- La limite stricte de Mask n’est pas respectée (débordement) : en observant le bord et la paroi intérieure du mug, on constate que la partie rouge corail initialement dans la zone protégée opaque a elle aussi été recolorée en bleu foncé. Dans le test géométrique plus extrême des « deux cercles », le cercle droit non masqué a également changé de couleur.
- Conseil d’utilisation : lors de l’envoi d’une image de référence et d’une Mask, assurez-vous qu’elles ont les mêmes dimensions de canevas (zone à modifier transparente, zone à préserver opaque) et indiquez dans le Prompt à la fois « ce qui doit changer » et « ce qui doit être conservé ». Pour les images commerciales industrielles avec logo de marque, petits textes d’emballage ou exigences strictes sur les contours, agrandissez l’image après génération et vérifiez les limites de la zone protégée.
7. Tarifs et coût réel d’utilisation : quel est le montant facturé ?
BetterToken maintient une tarification transparente. Voici l’instantané des prix publics au 19 octobre 2026 (CNY pour les comptes professionnels en renminbi, USD pour les comptes ordinaires en dollars ; ces tarifs sont indépendants et ne sont pas convertis selon le taux de change en temps réel) :
Selon ces prix publics, le coût indicatif pour 100 appels est le suivant, en supposant que les 100 images livrées relèvent effectivement du niveau de facturation concerné (estimation arithmétique) :
💡 Point essentiel pour le budget : calculez selon le « niveau réellement livré », et non selon les « paramètres demandés ». Comme le montrent les tests ci-dessus, certaines requêtes1024x1024(1K) envoyées aujourd’hui àflare,sunburstougpt-image-2ont livré des images1254×1254. Le système les classe alors au niveau 2K selon la dimension réelle (soit ¥0.15 ou ¥0.11, et non le tarif 1K de ¥0.035). Si les 100 requêtes1024x1024envoyées àflarerenvoyaient toutes1254×1254, le coût des 100 images aux tarifs actuels serait de ¥15.00 (estimation arithmétique). En outre, la classification tient compte de la dimension cible et d’un seuil d’écart raisonnable (par exemple,3840×2159est normalement classé en 4K, et1536×1024en 1K). Ne recalculez pas les frais côté application selon une règle simpliste telle que « le côté le plus long dépasse 1024 » ; le règlement est toujours déterminé par le champbettertoken_image_billingdu corps de réponse.
Pourquoi ne pas se fier uniquement au « faible prix par image » ?
Pour comparer les coûts des API d’image entre différentes plateformes, il est utile de calculer trois éléments :- Le tarif n’est comparable que si la réponse réelle atteint la dimension visée : une requête annoncée comme « compatible 4K à très bas prix », mais qui ne renvoie qu’une petite image réduite en 1024, ne peut pas être utilisée en production nécessitant des images haute définition et ne doit pas être comparée comme un tarif 4K valable.
- Intégrez les échecs et le coût des nouvelles tentatives dans le total : les tests de paramètres invalides de cette série n’ont pas été facturés ; lorsqu’une image est bien livrée mais ne répond pas au besoin, la soumettre à nouveau constitue une nouvelle requête à budgéter séparément. Les 4 images des exemples de produits et Mask de ce guide (3 générations + 1 retouche) ont chacune été livrées en un seul appel. L’échantillon Mask présente le débordement de couleur mentionné ci-dessus. Les tarifs unitaires étaient ¥0.11, ¥0.11, ¥0.13 et ¥0.11, soit un coût réel total de seulement ¥0.46 pour les 4 images ; la facture correspond exactement aux débits du compte. Si l’instabilité de la route ou l’incompatibilité des paramètres oblige à répéter les générations, le coût réel d’obtention d’un visuel utilisable peut augmenter même si le prix affiché par image est faible.
- Réduisez les coûts d’ingénierie d’adaptation cachés : grâce à la normalisation des paramètres, au routage intelligent selon les capacités et au retour en temps réel des pixels et champs de facturation réels, BetterToken réduit le travail consistant à adapter chaque service et à compiler séparément les dimensions et les coûts.
8. Exemples d’appels prêts à copier
Enregistrez votre BetterToken API Key dans la variable d’environnementBETTERTOKEN_API_KEY pour copier directement les commandes suivantes et commencer vos appels.
Exemple 1 : requête JSON pour générer une image de produit haute définition (POST /v1/images/generations)
L’exemple appelle gpt-image-2 pour générer une image de produit haute définition en 2048x2048 (model peut être remplacé directement par gpt-image-2.5-flare ou gpt-image-2.5-sunburst) :
- Remarque sur les dimensions : pour une image horizontale 4K, remplacez
"size"par"3840x2160"(n’utilisez pas"4096x4096"). Les dimensions valides doivent actuellement respecter les critères suivants : largeur et hauteur multiples de 16, côté le plus long inférieur ou égal à 3840, rapport entre le côté long et le côté court inférieur ou égal à 3:1, et nombre total de pixels compris entre655,360et8,294,400. - Remarque sur l’identification du format de fichier : même si la requête spécifie
"output_format": "png", certains nœuds sous-jacents peuvent renvoyer des données binaires au format JPEG. Lors de l’enregistrement ou du traitement de l’image, identifiez le format réel à partir de l’en-tête du fichier (Magic Bytes) plutôt que de coder l’extension en dur.
Exemple 2 : retouche locale Multipart avec image de référence et Mask (POST /v1/images/edits)
Préparez l’image d’origine product-1k-0.png et le masque transparent mask-mug.png de mêmes dimensions (si vous souhaitez uniquement une retouche classique à partir d’une image de référence, supprimez directement la ligne -F "mask=...") :
Exemple 3 : lecture des pixels livrés et des informations de facturation (structure de réponse et code d’analyse)
En plus dedata[].b64_json, le corps de réponse BetterToken contient aussi le nœud de champ étendu bettertoken_image_billing :
Références :